زیرساخت Private AI به سازمانها اجازه میدهد مدلهای زبانی بزرگ یا LLM را در محیط داخلی و تحت کنترل خود اجرا کنند؛ بهگونهای که دادههای حساس از محدوده دیتاسنتر سازمان خارج نشوند. در سالهای اخیر، افزایش استفاده از هوش مصنوعی مولد، نیاز به پردازش دادههای محرمانه و الزامات سختگیرانه امنیتی باعث شده است معماریهای On-Premises AI بیش از گذشته مورد توجه قرار بگیرند.
در واقع، اجرای یک LLM در محیط سازمانی فقط به خرید چند GPU و نصب یک مدل محدود نمیشود. بلکه یک پلتفرم Private AI باید مجموعهای از لایههای سختافزاری، مجازیسازی، شبکه، Kubernetes، سرویسهای مدل، کنترل دسترسی، امنیت، ذخیرهسازی و Observability را در کنار یکدیگر قرار دهد.
علاوه بر این، سازمان باید بتواند مدلهای مختلف را مدیریت کند، دسترسی کاربران را کنترل نماید، مصرف GPU و Token را مشاهده کند و در صورت بروز حادثه، مسیر کامل درخواستها و پاسخها را Audit کند.
به همین دلیل، Private AI را باید یک پلتفرم زیرساختی کامل دانست، نه صرفاً یک مدل هوش مصنوعی که روی یک سرور اجرا میشود.
⚠️ نکته مهم: اجرای LLM بهصورت On-Premises الزاماً به معنای امنیت کامل نیست. در صورتی که Network Isolation، کنترل Egress، Authentication، RBAC، mTLS، Audit Logging و حفاظت از Model Weights بهدرستی پیادهسازی نشوند، حتی یک محیط کاملاً داخلی نیز میتواند در معرض حملات سایبری و نشت داده قرار گیرد.
۱. چرا Private AI اهمیت پیدا کرده است؟
۱.۱ چالش Cloud در برابر On-Premises
بخش قابل توجهی از سرویسهای LLM امروزی از طریق APIهای ابری ارائه میشوند. این مدل برای بسیاری از کاربردها بسیار مناسب است؛ با این حال، زمانی که سازمان با اطلاعات محرمانه، دادههای شخصی یا Intellectual Property سروکار دارد، استفاده از API خارجی میتواند چالشهای جدی ایجاد کند.
از سوی دیگر، سازمانها معمولاً میخواهند دادهها را در محیطی پردازش کنند که کنترل کامل آن را در اختیار دارند. این مسئله باعث شکلگیری معماری Private AI شده است.
مهمترین محدودیتها و نگرانیها عبارتاند از:
- Data Sovereignty: صنایع تحت نظارت مانند Healthcare، Finance و Government ممکن است اجازه ارسال برخی دادهها به APIهای خارجی را نداشته باشند.
- Compliance: مقرراتی مانند GDPR، EU AI Act و قوانین تخصصی صنایع میتوانند محل و نحوه پردازش دادههای شخصی را محدود کنند.
- حفاظت از Intellectual Property: مدلهای Fine-Tuned میتوانند دانش اختصاصی سازمان را در خود داشته باشند و بنابراین باید بهشکل کنترلشده نگهداری شوند.
- هزینه قابل پیشبینی: در مدلهای Cloud، افزایش حجم Inference میتواند هزینه API را بهصورت قابل توجهی افزایش دهد.
در نتیجه، سازمانهایی که حجم بالایی از داده حساس یا درخواستهای AI دارند، ممکن است اجرای مدل در زیرساخت داخلی را گزینه مناسبتری بدانند.
۱.۲ ارزش Private AI برای سازمانها
Private AI میتواند چند مزیت مهم برای سازمان ایجاد کند.
داده در محدوده دیتاسنتر باقی میماند
در معماری On-Premises، دادههای ورودی و خروجی مدل در محیط تحت کنترل سازمان پردازش میشوند. بنابراین، سازمان کنترل بیشتری روی Data Residency و Data Sovereignty خواهد داشت.
API سازگار با OpenAI
یکی از مزایای مهم معماریهای مدرن Private AI، ارائه APIهای سازگار با OpenAI است.
در نتیجه، تیمهای توسعهدهنده میتوانند بدون تغییرات گسترده در Application Layer، مدلهای داخلی را جایگزین یا در کنار مدلهای Cloud استفاده کنند.
Self-Service AI
یک Private AI Platform مناسب میتواند به تیمهای توسعه اجازه دهد Model Endpoint ایجاد و مدیریت کنند؛ بدون اینکه هر Developer مجبور باشد با جزئیات Kubernetes یا زیرساخت GPU درگیر شود.
به این ترتیب، Platform Engineering نقش مهمی در ایجاد یک تجربه شبیه Cloud برای زیرساخت On-Premises خواهد داشت.
۲. معماری و بررسی فنی Private AI
یک پلتفرم Private AI سازمانی از چند لایه اصلی تشکیل میشود.
این لایهها معمولاً شامل Hardware، Virtualization، Networking، Kubernetes، Model Serving، Storage، Security، API Gateway و Observability هستند.
۲.۱ نمای کلی معماری Private AI
معماری پیشنهادی را میتوان به شکل زیر در نظر گرفت:
┌─────────────────────────────────────────────────────────────┐
│                     Enterprise Users                        │
│             Applications / Developers / Data               │
└────────────────────────────┬────────────────────────────────┘
                             │
                             ▼
┌─────────────────────────────────────────────────────────────┐
│                     Access & API Layer                       │
│ OpenAI-Compatible API · JWT · RBAC · Rate Limiting · mTLS   │
└────────────────────────────┬────────────────────────────────┘
                             │
                             ▼
┌─────────────────────────────────────────────────────────────┐
│                AI Services & Model Serving                   │
│      NVIDIA NIM · vLLM · TensorRT-LLM · Inference           │
│      Model Registry · Model Weights · Embeddings             │
└────────────────────────────┬────────────────────────────────┘
                             │
              ┌──────────────┴──────────────┐
              ▼                             ▼
┌─────────────────────────┐   ┌──────────────────────────────┐
│       RAG Pipeline      │   │       Vector Database        │
│ Ingest · Chunk · Embed  │──▶│ PostgreSQL + pgvector        │
│ Retrieve                │   │ Semantic Search              │
└─────────────────────────┘   └──────────────────────────────┘
                             │
                             ▼
┌─────────────────────────────────────────────────────────────┐
│              Virtualization & Orchestration                  │
│ VMware · vSphere · NSX · vSAN · vGPU · Kubernetes           │
└────────────────────────────┬────────────────────────────────┘
                             │
                             ▼
┌─────────────────────────────────────────────────────────────┐
│                   Hardware Infrastructure                    │
│ HGX · H100/H200 · NVLink · NVSwitch · RDMA · Networking     │
└─────────────────────────────────────────────────────────────┘

        Security + Observability across every layer
شکل ۱ – معماری لایهای زیرساخت Private AI برای اجرای امن LLM در محیط سازمانی
در این معماری، امنیت نباید فقط در یک نقطه پیادهسازی شود. بلکه Authentication، Authorization، Network Isolation، Egress Filtering، Audit Logging و Data Protection باید در چندین لایه اعمال شوند.
۲.۲ اجزای اصلی پلتفرم Private AI
زیرساخت سختافزاری
پلتفرمهای Private AI به زیرساخت High-Performance Computing نیاز دارند. طراحیهای پیشرفته معمولاً از سیستمهای NVIDIA-Certified HGX با چند GPU قدرتمند استفاده میکنند.
در طراحی مرجع مقاله، سیستمهایی با ۸× NVIDIA H100 یا H200 GPU و ارتباط پرسرعت NVLink و NVSwitch در نظر گرفته شدهاند.
با این حال، انتخاب سختافزار باید براساس اندازه مدل، تعداد کاربران، Throughput، Latency و نوع Workload انجام شود.
مهمترین ملاحظات سختافزاری عبارتاند از:
- GPU Density: تراکم بالای GPU میتواند بار حرارتی بسیار زیادی ایجاد کند.
- Interconnect: فناوریهایی مانند NVLink و NVSwitch ارتباط سریع میان GPUها را فراهم میکنند.
- Networking: شبکههای High-Speed و فناوریهایی مانند RDMA برای Clusterهای بزرگ اهمیت زیادی دارند.
- Power & Cooling: زیرساختهای AI به طراحی دقیق Power Distribution و Cooling نیاز دارند.
به همین دلیل، طراحی یک AI Cluster را نمیتوان صرفاً با معیار تعداد GPU انجام داد. Power، Cooling، Network Fabric و Storage نیز باید همزمان طراحی شوند.
مجازیسازی و Resource Pooling
فناوریهایی مانند NVIDIA vGPU امکان اشتراکگذاری منابع GPU میان چند Virtual Machine را فراهم میکنند.
در نتیجه، سازمان میتواند منابع سختافزاری را با انعطاف بیشتری میان Workloadهای مختلف توزیع کند.
Virtualization همچنین قابلیتهایی مانند:
- Snapshot
- vMotion
- Live Migration
- Resource Management
- Isolation
را در اختیار تیم زیرساخت قرار میدهد.
با این حال، استفاده از Virtualization برای AI Workload باید با دقت انجام شود؛ زیرا سربار Virtualization، نوع GPU، Memory Allocation و نیازهای Inference میتوانند روی Performance نهایی تأثیر بگذارند.
Model Serving و Inference
پس از آمادهسازی زیرساخت، مرحله بعدی اجرای مدلهاست.
در یک Private AI Platform، Model Serving Layer وظیفه دارد Model Endpointهایی را ایجاد کند که Applicationها و کاربران بتوانند از طریق API به آنها متصل شوند.
این لایه میتواند از فناوریهایی مانند:
- NVIDIA NIM
- vLLM
- TensorRT-LLM
- سایر Inference Engineها
استفاده کند.
علاوه بر این، سازمان میتواند چند نوع مدل را در یک Platform مدیریت کند:
Open-Weights Models
مدلهای دارای وزنهای قابل دسترس که در Model Registry سازمان نگهداری میشوند.
Fine-Tuned Models
مدلهایی که براساس داده یا نیاز یک حوزه خاص Fine-Tune شدهاند.
Custom Models
مدلهای اختصاصی که توسط تیم داخلی یا یک ارائهدهنده خارجی توسعه داده شدهاند.
در نتیجه، Model Registry باید نقش یک Repository کنترلشده برای مدیریت نسخه، دسترسی و چرخه عمر Model Artifactها را ایفا کند.
Vector Database و RAG Pipeline
یکی دیگر از اجزای مهم Private AI، معماری Retrieval-Augmented Generation یا RAG است.
RAG به مدل اجازه میدهد پیش از تولید پاسخ، اطلاعات مورد نیاز را از منابع داده سازمان بازیابی کند.
این منابع میتوانند شامل موارد زیر باشند:
- Google Drive
- Confluence
- SharePoint
- S3
- Object Storage
- MCP Servers
- Document Repositories
فرآیند معمول RAG شامل چند مرحله است:
Enterprise Data
      │
      ▼
   Ingestion
      │
      ▼
   Chunking
      │
      ▼
   Embedding
      │
      ▼
 Vector Database
      │
      ▼
 Semantic Retrieval
      │
      ▼
     LLM
      │
      ▼
   Final Answer
در معماری پیشنهادی، PostgreSQL + pgvector میتواند برای عملیات Vector Search استفاده شود.
با این حال، امنیت RAG نباید نادیده گرفته شود. اگر LLM با JWT و RBAC محافظت شود اما Vector Database بدون کنترل دسترسی مناسب در دسترس باشد، مهاجم یا یک Tenant دیگر ممکن است به دادههای حساس دسترسی پیدا کند.
بنابراین، Access Control باید تا لایه Retrieval و Document Level نیز ادامه پیدا کند.
امنیت داده و Compliance
در محیطهای سازمانی، یکی از مهمترین قابلیتهای Private AI، حفاظت از دادههای حساس است.
برای مثال، PII میتواند شامل موارد زیر باشد:
- نام و نام خانوادگی
- آدرس
- شمارههای شناسایی
- اطلاعات پزشکی
- اطلاعات مالی
- دادههای شخصی کارکنان و مشتریان
به همین دلیل، قابلیت PII Detection و Redaction باید قبل از ثبت اطلاعات در Log یا ارسال آنها به سرویسهای دیگر اعمال شود.
یک معماری مناسب میتواند PII Redaction را در API Gateway و AI Services Layer پیادهسازی کند.
در نتیجه، حتی در صورت فعال بودن Audit Logging، اطلاعات حساس نباید بدون کنترل در Log Storage ذخیره شوند.
۲.۳ گردش عملیاتی Private AI
چرخه پردازش یک درخواست در Private AI معمولاً به این شکل است:
User Request
     │
     ▼
API Gateway
     │
     ├── Authentication
     ├── Authorization
     ├── PII Redaction
     └── Rate Limiting
     │
     ▼
AI Orchestrator
     │
     ├── Intent Classification
     └── Model Routing
     │
     ├───────────────┐
     ▼               ▼
   RAG              LLM
     │               │
     ▼               ▼
Vector DB       Model Server
     │               │
     └───────┬───────┘
             ▼
        Final Response
             │
             ▼
      Audit + Telemetry
             │
             ▼
Prometheus / Grafana / OpenTelemetry
شکل ۲ – گردش درخواست در پلتفرم Private AI از Authentication تا Model Inference و Observability
در هر مرحله باید Security Control مناسب اعمال شود. برای مثال، Gateway میتواند Authentication و PII Redaction را انجام دهد؛ Orchestrator وظیفه Routing را بر عهده بگیرد؛ Model Server عملیات Inference را انجام دهد؛ و در نهایت Observability Layer اطلاعات Performance و Audit را جمعآوری کند.
نمونه Configuration برای Container امن
برای یک محیط حساس مانند Healthcare، میتوان Container را با محدودیتهای امنیتی بیشتری اجرا کرد:
services:
  llm-inference:
    image: vllm/vllm-openai:v0.4.2
    read_only: true
    security_opt:
      - no-new-privileges:true
    cap_drop:
      - ALL
    cap_add:
      - SYS_NICE
    volumes:
      - /encrypted-storage/models:/models:ro
    networks:
      - inference_internal
در این Configuration، فایلسیستم Container بهصورت Read-Only اجرا میشود و Capabilityهای غیرضروری حذف میشوند.
علاوه بر این، Model Storage بهصورت Read-Only Mount شده است تا Runtime نتواند Model Artifactها را تغییر دهد.
این نوع Hardening بهتنهایی کافی نیست؛ با این حال، یکی از لایههای مهم Defense-in-Depth در Private AI محسوب میشود.
۳. مقایسه Cloud API و Private AI
| معیار | Cloud API | Private AI Infrastructure |
|---|---|---|
| Data Sovereignty | داده از محیط سازمان خارج میشود | داده در محیط سازمان باقی میماند |
| Model Access | معمولاً براساس API Call | کنترل کاملتر روی مدل |
| Latency | وابسته به شبکه و سرویس Cloud | قابل کنترلتر در محیط داخلی |
| Security | وابسته به Provider و API Security | کنترل چندلایه داخلی |
| Customization | محدودتر | Fine-Tuning و LoRA |
| Cost Model | معمولاً Per-Token | هزینه زیرساخت داخلی |
| Vendor Lock-in | احتمال وابستگی بیشتر | امکان استفاده از Abstraction Layer |
| Audit | وابسته به قابلیت Provider | کنترل کاملتر روی Logging و Audit |
همانطور که جدول بالا نشان میدهد، Private AI لزوماً در تمام شرایط گزینه بهتر نیست. با این حال، برای سازمانهایی که Data Sovereignty، Compliance، کنترل امنیتی و حجم بالای Inference اهمیت زیادی دارد، معماری On-Premises میتواند مزیت قابل توجهی ایجاد کند.
بنابراین، تصمیم میان Cloud و Private AI باید براساس Workload، حجم داده، الزامات قانونی، هزینه، مهارت تیم و مدل تهدید سازمان انجام شود.
۴. کاربردهای Private AI در سازمانها
۴.۱ اجرای LLM در صنایع تحت نظارت
فرض کنید یک سازمان Healthcare قصد دارد یک LLM را برای بیش از ۱۰,۰۰۰ کاربر بالینی اجرا کند.
در چنین محیطی، ارسال دادههای بیمار به API خارجی میتواند با محدودیتهای جدی مواجه باشد. بنابراین، سازمان به یک معماری On-Premises با قابلیت Audit و Data Isolation نیاز خواهد داشت.
در این سناریو، معماری پیشنهادی شامل موارد زیر است:
- GPU Infrastructure داخلی
- Kubernetes
- Model Registry
- API Gateway
- PII Redaction
- Vector Database
- Network Isolation
- Egress Filtering
- Audit Logging
در نتیجه، دادههای حساس در محیط کنترلشده باقی میمانند و دسترسی به منابع مختلف نیز براساس Identity و Policy مدیریت میشود.
۴.۲ Enterprise AI Gateway چندمستاجری
در سازمانهای بزرگ، ممکن است چندین Business Unit به مدلهای مختلف AI نیاز داشته باشند.
بدون یک Gateway مرکزی، هر تیم ممکن است از Provider متفاوتی استفاده کند. در نتیجه، کنترل امنیتی، مدیریت Credential و مشاهده هزینهها دشوار خواهد شد.
یک AI Gateway مرکزی میتواند:
- Authentication را مدیریت کند.
- RBAC را اعمال کند.
- Rate Limiting داشته باشد.
- Model Routing انجام دهد.
- API Keyها را مدیریت کند.
- Token Usage را ثبت کند.
- Audit Log تولید کند.
- Traffic را بین نسخههای مختلف مدل توزیع کند.
برای مثال، یک Gateway میتواند براساس Header درخواست، مدل مورد نظر را انتخاب کند:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: ai-inference-routing
spec:
  rules:
  - matches:
    - headers:
      - name: model
        value: "llama-3-70b"
    backendRefs:
    - name: inferencepool-llama
      port: 8080

  - matches:
    - headers:
      - name: model
        value: "deepseek-coder"
    backendRefs:
    - name: inferencepool-deepseek
      port: 8080
به این ترتیب، Gateway میتواند یک Abstraction Layer میان Applicationها و Model Infrastructure ایجاد کند.
۵. چالشها و محدودیتهای Private AI
Private AI مزایای قابل توجهی دارد؛ با این حال، اجرای آن بدون چالش نیست.
۵.۱ محدودیتهای سختافزاری و زیرساختی
GPU Density و Power
GPUهای مدرن توان مصرفی و تراکم حرارتی بالایی دارند. در Clusterهای متراکم، طراحی سنتی دیتاسنتر ممکن است پاسخگوی نیازهای AI نباشد.
به همین دلیل، در Deploymentهای High-Density ممکن است استفاده از Liquid Cooling ضروری شود.
Resource Utilization
یکی دیگر از چالشها، استفاده ناکافی از GPU در ساعات کمبار است.
برای مثال، اگر یک Model Endpoint در ساعات شب درخواست بسیار کمی دریافت کند، نگه داشتن GPU در حالت مصرف کامل منابع میتواند هزینه قابل توجهی ایجاد کند.
بنابراین، Orchestration باید بتواند Workloadها را براساس Demand مقیاس کند.
۵.۲ بردارهای حمله امنیتی
| Threat Vector | Mitigation |
|---|---|
| Malicious Model Weights | Network Isolation و Egress Filtering |
| Supply Chain Attack | Firewalling و Isolation Monitoring |
| Web Application Compromise | Reverse Proxy Hardening و Container Hardening |
| Credential Theft | Secret Management و Read-Only Mount |
| Prompt Injection | Trust-Aware Orchestration و Human Review |
در نتیجه، امنیت Private AI باید فراتر از Model Endpoint طراحی شود.
یک مدل مخرب، Container آسیبپذیر یا Credential سرقتشده میتواند به نقطه شروع یک زنجیره حمله تبدیل شود.
۵.۳ پیچیدگی عملیاتی
یک Private AI Platform معمولاً چندین حوزه تخصصی را همزمان درگیر میکند:
- Server Infrastructure
- GPU Management
- Virtualization
- Kubernetes
- Networking
- Storage
- Model Serving
- Cybersecurity
- Observability
- Identity Management
به همین دلیل، سازمان برای بهرهبرداری صحیح از چنین پلتفرمی به تیمی با مهارتهای چندرشتهای نیاز دارد.
از سوی دیگر، هزینه Private AI فقط هزینه GPU نیست. Cooling، Networking، Storage، Engineering، Maintenance و Security نیز باید در محاسبات TCO در نظر گرفته شوند.
۶. بهترین روشهای مهندسی Private AI
۶.۱ چکلیست امنیتی
برای ایجاد یک Private AI Platform امن، موارد زیر باید در طراحی لحاظ شوند:
- Network Isolation: اجرای Workloadهای AI در شبکههای داخلی و اعمال Default-Deny Egress
- Container Hardening: اجرای Containerها با Non-Root User و حذف Capabilityهای غیرضروری
- mTLS: احراز هویت متقابل میان سرویسها
- API Key Rotation: چرخش دورهای کلیدها و امکان Revocation فوری
- Read-Only Model Storage: جلوگیری از تغییر Model Weights توسط Runtime
- Vector Database Access Control: اعمال RBAC و Tenant Isolation روی Vector Database
- TLS Certificate Validation: اعتبارسنجی دقیق Certificateها
- PII Redaction: حذف یا Mask کردن دادههای حساس پیش از Logging یا Storage
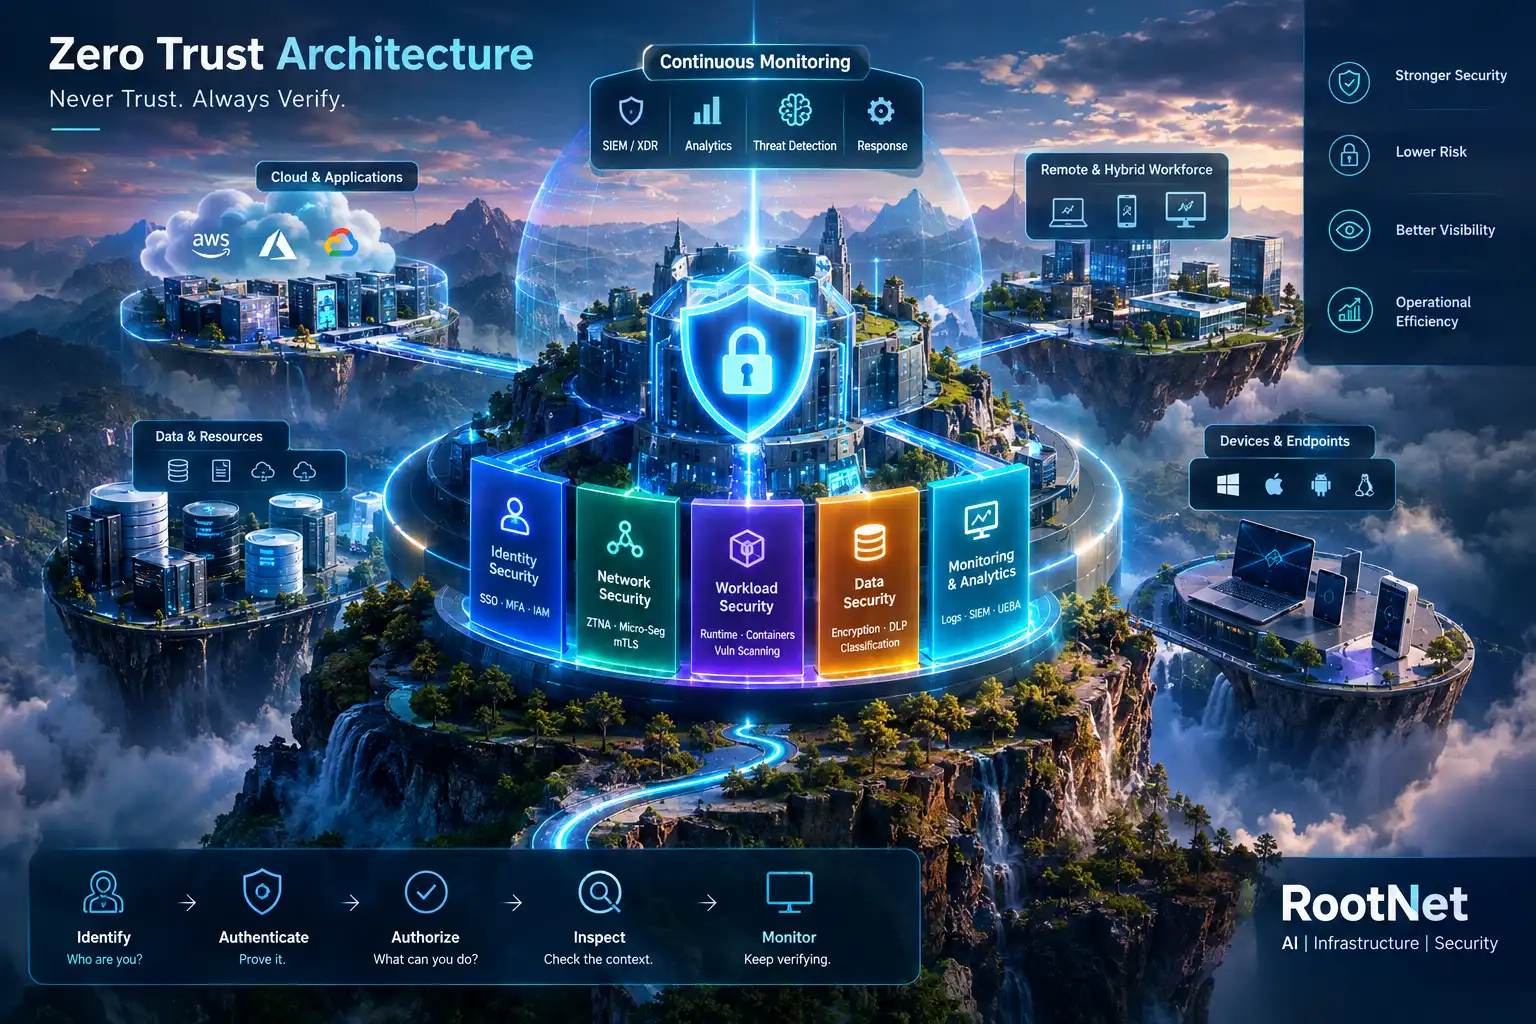
علاوه بر این، Network داخلی نباید بهعنوان یک Trust Boundary مطلق در نظر گرفته شود. در یک معماری Zero-Trust، هر سرویس باید Identity خود را اثبات کرده و براساس Policy مجاز به دسترسی باشد.
6.2 Observability
یک Private AI Platform بدون Observability مناسب، برای محیط Production قابل اتکا نیست.
بنابراین باید حداقل شاخصهای زیر مانیتور شوند:
- GPU Utilization
- GPU Memory
- GPU Temperature
- Power Consumption
- Input Tokens
- Output Tokens
- Request Latency
- Model Usage
- Error Rate
- Audit Events
ابزارهایی مانند Prometheus، Grafana و OpenTelemetry میتوانند برای جمعآوری و نمایش این Telemetry مورد استفاده قرار گیرند.
در نهایت، ترکیب GPU Telemetry با Application Telemetry امکان تحلیل دقیقتر Performance و Capacity را فراهم میکند.
۶.۳ بهینهسازی هزینه
برای کاهش هزینههای عملیاتی، چند رویکرد مهم وجود دارد.
Idle Scaling
مدلهایی که برای مدت مشخصی بدون درخواست هستند میتوانند Scale Down شوند.
Model Routing
درخواستهای ساده میتوانند به مدلهای سبکتر ارسال شوند؛ در مقابل، Workloadهای پیچیده به مدلهای بزرگتر منتقل شوند.
Persistent Model Cache
ذخیره Model Weights در Storage داخلی میتواند Cold Start را کاهش دهد.
Resource Requests و Limits
تعریف دقیق CPU، Memory و GPU Resource باعث میشود منابع بیش از نیاز واقعی تخصیص داده نشوند.
به این ترتیب، ظرفیت GPU براساس داده واقعی مصرف و Workload برنامهریزی میشود، نه صرفاً براساس Peak Capacity.
۷. آینده معماری Private AI
7.1 Confidential Computing
یکی از روندهای مهم آینده، استفاده از Confidential Computing برای محافظت همزمان از Model IP و Enterprise Data است.
در چنین معماریهایی، سختافزار و Runtime میتوانند از طریق فرآیند Attestation بررسی شوند.
سرویس Key Release تنها زمانی Model Weights را در اختیار محیط اجرا قرار میدهد که شواهد Attestation معتبر باشند.
در نتیجه، حتی مالک مدل و مالک داده میتوانند بدون اعتماد کامل به یکدیگر، کنترل بیشتری روی داراییهای خود داشته باشند.
۷.۲ Agentic AI و Automation
نسل آینده Private AI فقط به Chatbot محدود نخواهد بود.
AI Agentها میتوانند وظایف چندمرحلهای را بهصورت خودکار انجام دهند؛ برای مثال:
User Request
      ↓
AI Agent
      ↓
Intent Analysis
      ↓
Policy Check
      ↓
Tool Selection
      ↓
System Action
      ↓
Verification
      ↓
Audit Log
با این حال، افزایش Autonomous Action سطح ریسک را نیز افزایش میدهد.
به همین دلیل، Agentها باید با Sandbox، Egress Control، Policy Enforcement و Human Approval برای عملیات حساس اجرا شوند.
۷.۳ تحول زیرساخت GPU
روند توسعه Hardware نشان میدهد که تراکم GPU در دیتاسنترها همچنان افزایش خواهد یافت.
در نتیجه، موضوعاتی مانند:
- Liquid Cooling
- High-Speed Networking
- RDMA
- NVLink
- NVSwitch
- GPU Scheduling
- Power Management
اهمیت بیشتری پیدا خواهند کرد.
بنابراین، دیتاسنترهای آینده برای AI باید از ابتدا با نگاه AI Infrastructure طراحی شوند، نه اینکه صرفاً سرورهای GPU به دیتاسنترهای سنتی اضافه شوند.
۸. دیدگاه مهندسی RootNet
Private AI یک پروژه صرفاً نرمافزاری نیست. در واقع، این معماری یک Integration Challenge چندلایه است که Hardware، Virtualization، Networking، Kubernetes، Security، Storage و AI Services را به یکدیگر متصل میکند.
در RootNet، نگاه مهندسی به Private AI بر سه محور اصلی متمرکز است:
Security-First Architecture
Isolation، Egress Control، mTLS، Authentication و Audit Logging باید از ابتدا در معماری قرار بگیرند.
به بیان دیگر، امنیت نباید مرحلهای باشد که بعد از Deploy شدن مدل به سیستم اضافه شود.
Cost-Aware Orchestration
GPU یک منبع گرانقیمت است. بنابراین، Platform باید براساس Telemetry واقعی، ظرفیت مورد نیاز را مدیریت کند.
به همین دلیل، هدف باید این باشد که GPU زمانی مصرف شود که واقعاً برای پردازش Workload مورد نیاز است.
Observability
در Private AI، تنها مشاهده CPU و RAM کافی نیست.
مدیر زیرساخت باید بتواند رابطه میان GPU Utilization، Token Usage، Latency، Model Performance و Application Behaviour را بررسی کند.
در نتیجه، Observability میتواند به Capacity Planning، Predictive Maintenance و بهینهسازی هزینه کمک کند.
چالش واقعی Private AI انتخاب مدل یا نوشتن Prompt نیست؛ بلکه ساخت یک پلتفرم امن، قابل مشاهده، مقیاسپذیر و مقرونبهصرفه است که پیچیدگی زیرساخت را از دید Developer پنهان کند و همزمان کنترلهای Enterprise را حفظ نماید.
۹. سوالات متداول (FAQ)
حداقل سختافزار مورد نیاز برای اجرای LLM بهصورت On-Premises چیست؟
نیاز سختافزاری کاملاً به اندازه مدل، نوع Precision، تعداد کاربران و نوع Inference بستگی دارد. برای Deploymentهای بزرگ میتوان از سیستمهای چند GPU مانند HGX استفاده کرد؛ در حالی که برای محیطهای Development یا Workloadهای کوچکتر، یک سرور دارای چند GPU نیز ممکن است کافی باشد.
برای مثال، یک مدل 70B در FP16 به حدود 140GB حافظه GPU برای نگهداری وزنها نیاز دارد. بنابراین، یک GPU با 40GB VRAM برای اجرای مستقیم چنین مدلی در FP16 کافی نیست.
Private AI چگونه Multi-Tenant Isolation را پیادهسازی میکند؟
Isolation باید در چند سطح اعمال شود. Kubernetes Namespace میتواند Workloadها را جدا کند؛ Vector Database میتواند Namespaceهای مجزا داشته باشد؛ و JWT/RBAC نیز دسترسی کاربران به مدلها و دادهها را محدود کند.
در نتیجه، Tenant Isolation باید در Model، API، Storage، Vector Database و Audit Log همزمان رعایت شود.
Trust-Aware Orchestration چیست؟
Trust-Aware Orchestration به معنای بررسی درخواستها پیش از اجرای آنها براساس Policyهای مشخص است.
درخواستهای حساس یا Action-Oriented میتوانند نیازمند Schema Validation، Authorization، Tenant Scope و Human Approval باشند.
به این ترتیب، مدل نمیتواند صرفاً براساس یک Prompt، عملیات حساس را بدون کنترل انجام دهد.
هزینه Private AI در مقایسه با Cloud API چگونه است؟
Cloud API معمولاً براساس Token یا Request هزینه دریافت میکند. در مقابل، Private AI به سرمایهگذاری اولیه در GPU، Storage، Networking، Cooling و Engineering نیاز دارد.
بنابراین، انتخاب میان این دو مدل باید براساس حجم Workload، الزامات امنیتی، هزینه زیرساخت و ظرفیت تیم فنی انجام شود.
RAG در Private AI چه ملاحظات امنیتی دارد؟
RAG باید همان سطح کنترل دسترسی LLM Endpoint را روی Vector Database و Document Store نیز اعمال کند.
اگر کاربر به یک سند دسترسی نداشته باشد، Retrieval Layer نباید آن سند را بهعنوان Context در اختیار مدل قرار دهد.
به همین دلیل، Document-Level Authorization باید در مرحله Retrieval اعمال شود، نه فقط در Application Layer.
Model Versioning در محیط Production چگونه انجام میشود؟
روشهایی مانند Blue-Green Deployment، Canary Deployment و Weighted Routing امکان انتشار تدریجی مدل جدید را فراهم میکنند.
برای مثال، میتوان ابتدا درصد محدودی از Traffic را به مدل جدید ارسال کرد و پس از بررسی Latency، Error Rate و کیفیت خروجی، Traffic را افزایش داد.
آیا Unix Socket برای Model Serving مفید است؟
در برخی سناریوهای داخلی، Unix Socket میتواند سربار Networking را کاهش دهد و Attack Surface را کوچکتر کند.
با این حال، این روش برای همه معماریها مناسب نیست و در محیطهای Distributed ممکن است انعطافپذیری TCP/IP مورد نیاز باشد.
Confidential Computing چگونه از Model IP محافظت میکند؟
Confidential Computing میتواند با استفاده از Attestation مشخص کند که مدل در یک محیط تأییدشده اجرا میشود.
در چنین معماریای، Model Weights میتوانند تنها پس از تأیید وضعیت Hardware و Runtime در اختیار محیط اجرا قرار گیرند.
چرا PII Redaction در Private AI مهم است؟
PII Redaction از ثبت یا انتشار اطلاعات حساس در Logها، APIها و سایر سیستمها جلوگیری میکند.
در نتیجه، دادههایی مانند اطلاعات پزشکی، مالی یا هویتی میتوانند پیش از ذخیره یا پردازش بیشتر Mask شوند.
Object Storage چه نقشی در Private AI دارد؟
Object Storage برای ذخیره Model Weights و همچنین نگهداری Documentهای مورد استفاده در RAG کاربرد دارد.
به دلیل حجم بالای Model Artifactها، استفاده از Storage مقیاسپذیر میتواند مدیریت و توزیع مدلها را در Cluster سادهتر کند.
جمعبندی
Private AI Infrastructure یکی از مهمترین معماریهای در حال رشد برای سازمانهایی است که میخواهند از قابلیتهای LLM و Generative AI استفاده کنند، اما در عین حال کنترل بیشتری روی داده، امنیت، هزینه و مدلهای خود داشته باشند.
با این حال، ساخت یک Private AI Platform موفق فقط به خرید GPU و نصب LLM خلاصه نمیشود.
یک معماری Enterprise باید Hardware، Networking، Virtualization، Kubernetes، Model Serving، RAG، Vector Database، Identity، Security و Observability را بهصورت یکپارچه مدیریت کند.
از سوی دیگر، افزایش استفاده از AI Agentها و مدلهای بزرگتر باعث خواهد شد نیاز به GPUهای قدرتمندتر، شبکههای سریعتر، Cooling پیشرفتهتر و Security Controlهای دقیقتر افزایش پیدا کند.
در نهایت، موفقیت Private AI به توانایی سازمان در ایجاد تعادل میان Performance، Security، Compliance، Cost و Developer Experience بستگی دارد.
چکلیست نهایی Private AI
طراحی معماری Secure-by-Design
جداسازی Network و Workload
پیادهسازی RBAC و Authentication
استفاده از mTLS برای ارتباط سرویسها
کنترل Egress
حفاظت از Model Weights
امنیت Vector Database
PII Detection و Redaction
GPU و Infrastructure Monitoring
Token و Model Analytics
Audit Logging
Backup و Disaster Recovery
Capacity Planning
Model Versioning و Canary Deployment
RootNet در حوزه طراحی و پیادهسازی زیرساختهای شبکه، دیتاسنتر، امنیت و پلتفرمهای Enterprise AI فعالیت میکند. برای سازمانهایی که به دنبال طراحی زیرساخت Private AI، GPU Infrastructure، Network Architecture، Security Hardening و Observability هستند، میتوان معماری را براساس نیاز واقعی Workload و الزامات امنیتی طراحی کرد.
دیدگاه ها بسته هستند