شبکههای سازمانی دیگر محدود به چند سوئیچ، روتر و سرور در یک دیتاسنتر نیستند. امروزه زیرساختهای IT ترکیبی از دیتاسنترها، سرویسهای ابری، شعب سازمان، کاربران راه دور، ماشینهای مجازی، کانتینرها، SaaS و سرویسهای حیاتی کسبوکار هستند.
در چنین محیطی، مانیتورینگ سنتی شبکه معمولاً زمانی به تیم IT هشدار میدهد که یک مشکل رخ داده یا عملکرد یک سرویس از یک آستانه مشخص عبور کرده است.
اما یک رویکرد جدیدتر در حال تغییر نحوه مدیریت زیرساخت است:
Predictive Network Monitoring یا مانیتورینگ پیشبینانه شبکه
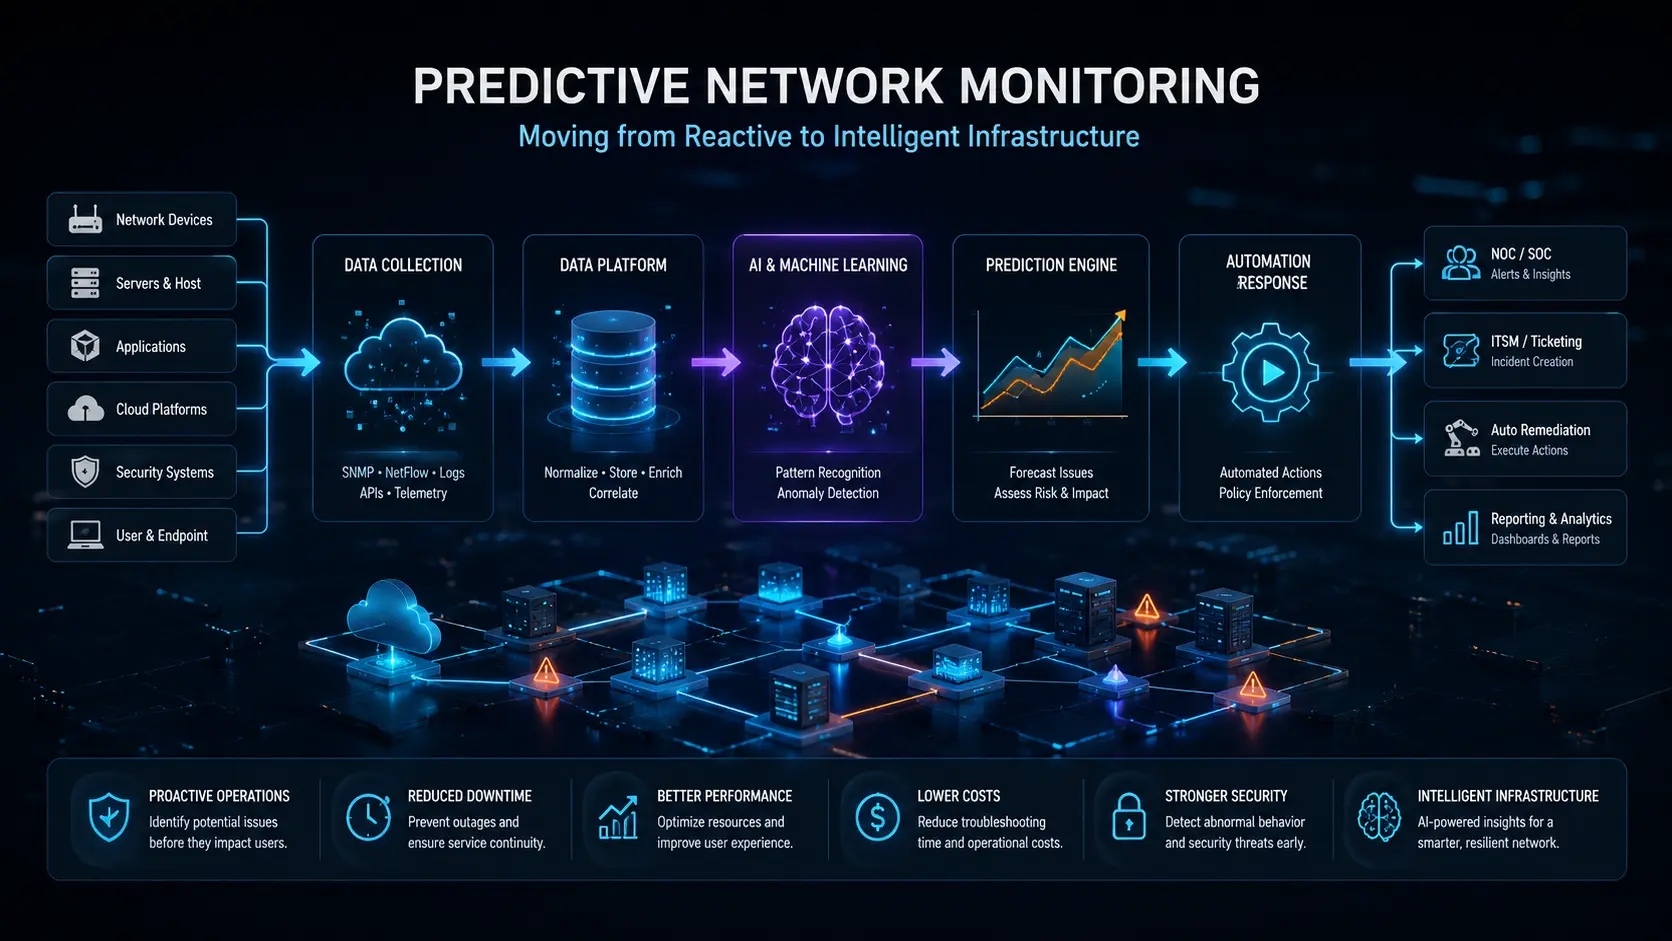
در این روش، دادههای لحظهای شبکه با دادههای تاریخی، تحلیل رفتار، یادگیری ماشین، تشخیص ناهنجاری و AIOps ترکیب میشوند تا نشانههای اولیه مشکلات شناسایی شوند؛ حتی قبل از اینکه اختلال جدی در سرویس ایجاد شود.
هدف فقط تولید هشدار بیشتر نیست.
هدف این است که تیمهای شبکه و زیرساخت بتوانند زودتر متوجه تغییرات شوند، علت احتمالی را بهتر درک کنند و قبل از تبدیل شدن یک مشکل کوچک به قطعی بزرگ، اقدام کنند.
مانیتورینگ پیشبینانه شبکه چیست؟
مانیتورینگ پیشبینانه شبکه یک رویکرد مبتنی بر هوش مصنوعی و تحلیل داده است که با استفاده از اطلاعات فعلی و تاریخی شبکه، الگوهای رفتاری را شناسایی کرده و احتمال وقوع مشکلات آینده را تخمین میزند.
در مانیتورینگ سنتی، معمولاً از Threshold استفاده میشود:
- CPU بالاتر از ۹۰٪ → هشدار
- Packet Loss بالاتر از ۵٪ → هشدار
- مصرف لینک بالاتر از ۸۰٪ → هشدار
این روش همچنان کاربردی است، اما یک سؤال مهم را پاسخ نمیدهد:
آیا این وضعیت در حال تبدیل شدن به یک مشکل جدی است؟
فرض کنید مصرف یک لینک طی چند هفته از ۵۰٪ به ۶۰٪ و سپس به ۷۰٪ رسیده است.
ممکن است هنوز هیچ Thresholdی فعال نشده باشد.
اما یک سیستم Predictive Monitoring میتواند این روند را شناسایی کند و بگوید:
اگر روند فعلی ادامه پیدا کند، این لینک احتمالاً در آینده نزدیک به نقطه بحرانی خواهد رسید.
این تفاوت اصلی میان Monitoring واکنشی و Monitoring پیشبینانه است.
تفاوت مانیتورینگ سنتی و مانیتورینگ پیشبینانه
| قابلیت | مانیتورینگ سنتی | مانیتورینگ پیشبینانه |
|---|---|---|
| هدف اصلی | شناسایی مشکل فعلی | شناسایی مشکل احتمالی آینده |
| داده | بیشتر دادههای لحظهای | داده تاریخی + لحظهای |
| Alerting | مبتنی بر Threshold | مبتنی بر رفتار و Context |
| تشخیص ناهنجاری | محدود | پیشرفته |
| تحلیل روند | پایه | مستمر و هوشمند |
| Machine Learning | معمولاً محدود | بخش اصلی سیستم |
| پیشبینی ریسک | محدود | قابلیت کلیدی |
| Root Cause Analysis | اغلب دستی | AI-Assisted |
| Automation | محدود | قابل توسعه |
| مدل عملیاتی | Reactive | Proactive |
به زبان ساده:
مانیتورینگ سنتی میپرسد: «الان چه چیزی خراب است؟»
اما مانیتورینگ پیشبینانه میپرسد:
«چه چیزی در حال تغییر است، چرا تغییر کرده و اگر این روند ادامه پیدا کند چه اتفاقی خواهد افتاد؟»
چرا مانیتورینگ سنتی شبکه دیگر کافی نیست؟
زیرساختهای مدرن حجم بسیار زیادی از Telemetry تولید میکنند.
یک سازمان بزرگ ممکن است همزمان دادههایی از منابع زیر دریافت کند:
- Router
- Switch
- Firewall
- Load Balancer
- Wireless Controller
- Server
- Virtual Machine
- Container
- Cloud Workload
- Database
- Application
- API
- Endpoint
- Security Platform
این دادهها میتوانند شامل:
- Metrics
- Logs
- Network Flows
- Events
- Configuration Data
- Performance Data
باشند.
مشکل اصلی دیگر کمبود داده نیست.
مشکل، تشخیص سیگنال مهم در میان حجم عظیم داده است.
این همان جایی است که مفهوم AI-Powered Network Monitoring اهمیت پیدا میکند.
هوش مصنوعی میتواند رویدادهای مختلف را با یکدیگر Correlate کند، رفتار عادی شبکه را یاد بگیرد، Anomalyها را شناسایی کند و هشدارها را بر اساس اهمیت و ریسک اولویتبندی کند.
مانیتورینگ پیشبینانه شبکه چگونه کار میکند؟
یک معماری کامل برای Predictive Network Monitoring معمولاً از چند لایه تشکیل میشود.
۱. جمعآوری Telemetry
اولین مرحله، جمعآوری دادههای قابل اعتماد از زیرساخت است.
منابع رایج شامل موارد زیر هستند:
- SNMP
- NetFlow
- sFlow
- Syslog
- REST API
- Network Metrics
- Application Telemetry
- Security Events
- Cloud Telemetry
هرچه دادههای ورودی کاملتر و باکیفیتتر باشند، مدلهای تحلیلی نیز عملکرد بهتری خواهند داشت.
داده ضعیف، پیشبینی ضعیف ایجاد میکند.
۲. نرمالسازی دادهها
در شبکههای Enterprise معمولاً تجهیزات چندین Vendor مختلف وجود دارند.
Cisco، HPE، MikroTik، Juniper، Fortinet و سایر پلتفرمها ممکن است دادههای مشابه را با ساختارهای متفاوت تولید کنند.
بنابراین دادهها باید قبل از تحلیل، Normalization شوند.
این کار باعث میشود سیستم بتواند رفتار تجهیزات مختلف را در یک مدل تحلیلی مشترک بررسی کند.
۳. غنیسازی داده با Context
یک Metric بهتنهایی همیشه معنی مشخصی ندارد.
برای مثال:
CPU = 90%
این عدد ممکن است در یک سرور کاملاً طبیعی باشد و در سرور دیگری نشانه یک مشکل جدی.
سیستم هوشمند باید بتواند این داده را با اطلاعات دیگری مانند:
- نوع سرویس
- زمان
- ترافیک شبکه
- Application Performance
- کاربران
- تغییرات Configuration
- رخدادهای امنیتی
- سابقه مشکلات
ترکیب کند.
در نتیجه، به جای یک Alert ساده، یک Operational Context ایجاد میشود.
نقش Machine Learning در Predictive Network Monitoring
یکی از مهمترین تفاوتهای مانیتورینگ پیشبینانه با Monitoring سنتی، استفاده از Machine Learning برای شناخت رفتار عادی زیرساخت است.
فرض کنید یک سازمان هر روز بین ساعت ۸ تا ۱۰ صبح افزایش مشخصی در ترافیک شبکه دارد.
یک Threshold ساده ممکن است این افزایش را بهعنوان یک Alert ثبت کند.
اما یک مدل یادگیری ماشین میتواند متوجه شود که این رفتار:
Normal Business Behavior
است.
در مقابل، اگر همان افزایش ترافیک در ساعت ۳ بامداد اتفاق بیفتد، ممکن است رفتار غیرعادی تلقی شود.
بنابراین AI میتواند به جای تکیه صرف بر Thresholdهای ثابت، Baseline رفتاری برای زیرساخت ایجاد کند.
تشخیص Anomaly در شبکه
Anomaly Detection یکی از مهمترین قابلیتهای Predictive Network Monitoring است.
سیستم با بررسی رفتار تاریخی میتواند الگوهای معمول را شناسایی کند.
سپس هرگونه انحراف قابلتوجه از این الگوها را بررسی میکند.
برای مثال:
- افزایش غیرعادی Latency
- افزایش Packet Loss
- تغییر ناگهانی Traffic Pattern
- افزایش Retransmission
- افت Throughput
- افزایش Error Rate
- تغییر غیرعادی مصرف Bandwidth
- رفتار غیرمعمول یک Application
ممکن است نشانه یک مشکل در حال شکلگیری باشد.
نکته مهم این است که Anomaly الزاماً به معنی Incident نیست.
سیستم باید بتواند شدت، احتمال و تأثیر احتمالی آن را نیز ارزیابی کند.
Predictive Maintenance برای زیرساخت شبکه
یکی از کاربردهای مهم این فناوری، Predictive Maintenance است.
به جای اینکه تیم IT منتظر خرابی تجهیزات بماند، میتوان از روند دادهها برای شناسایی نشانههای اولیه خرابی استفاده کرد.
برای مثال:
افزایش Error → افزایش Retransmission → افت Performance → احتمال خرابی یا اختلال
با شناسایی زودهنگام این الگو، تیم زیرساخت میتواند قبل از وقوع قطعی:
- تجهیزات را بررسی کند
- ظرفیت را افزایش دهد
- Configuration را اصلاح کند
- مسیر ترافیک را تغییر دهد
- Hardware را تعویض کند
- یا Maintenance برنامهریزیشده انجام دهد.
این تغییر، مدیریت زیرساخت را از یک مدل Reactive به یک مدل Proactive تبدیل میکند.
نقش AIOps در مانیتورینگ پیشبینانه
Predictive Network Monitoring ارتباط نزدیکی با AIOps دارد.
AIOps با استفاده از هوش مصنوعی و Machine Learning به سازمانها کمک میکند حجم بالای دادههای IT را تحلیل کرده و رویدادهای مرتبط را به یکدیگر متصل کنند.
برای مثال، یک کاهش Performance ممکن است همزمان چندین Alert ایجاد کند:
- High CPU
- Network Latency
- Packet Loss
- Application Timeout
- Database Delay
در یک سیستم سنتی، این موارد ممکن است چند Incident جداگانه به نظر برسند.
اما یک سیستم AIOps میتواند تشخیص دهد که همه این رخدادها احتمالاً از یک Root Cause مشترک ناشی شدهاند.
در نتیجه:
Hundreds of alerts → One correlated incident
این قابلیت میتواند به شکل قابلتوجهی Alert Fatigue را کاهش دهد.
مزایای Predictive Network Monitoring
پیادهسازی صحیح مانیتورینگ پیشبینانه میتواند مزایای متعددی برای سازمان ایجاد کند.
کاهش Downtime
شناسایی زودهنگام مشکلات باعث میشود تیم IT قبل از تبدیل شدن یک مشکل به Outage واکنش نشان دهد.
کاهش MTTR
وقتی هشدارها با Context و Root Cause احتمالی همراه باشند، زمان تشخیص و رفع مشکل کاهش پیدا میکند.
کاهش Alert Fatigue
AI میتواند رویدادهای مرتبط را Correlate کرده و هشدارهای کماهمیت را از Incidentهای واقعی جدا کند.
مدیریت بهتر ظرفیت
تحلیل روند مصرف منابع به تیم زیرساخت کمک میکند قبل از رسیدن تجهیزات به نقطه بحرانی، Capacity Planning انجام دهد.
افزایش Network Visibility
ترکیب دادههای شبکه، سرور، Application و Cloud دید جامعتری از وضعیت زیرساخت ایجاد میکند.
تصمیمگیری مبتنی بر داده
به جای اتکا به حدس یا واکنش دستی، تصمیمهای عملیاتی بر اساس داده و روندهای واقعی گرفته میشوند.
Predictive Network Monitoring و Hybrid Cloud
زیرساختهای امروزی فقط در دیتاسنتر سازمان قرار ندارند.
بسیاری از شرکتها از معماری Hybrid Cloud استفاده میکنند که در آن بخشی از Workloadها در دیتاسنتر و بخشی در Cloud قرار دارند.
این موضوع پیچیدگی Monitoring را افزایش میدهد.
یک سیستم Predictive Monitoring مدرن باید بتواند دادههای محیطهای مختلف را در کنار یکدیگر تحلیل کند.
برای مثال:
On-Premises Network + Virtual Infrastructure + Cloud + Application + Security
وقتی این دادهها در یک مدل تحلیلی مشترک قرار بگیرند، تشخیص وابستگی میان سرویسها بسیار سادهتر میشود.
آیا Predictive Monitoring جایگزین Network Monitoring سنتی میشود؟
خیر.
این دو فناوری رقیب یکدیگر نیستند.
Predictive Network Monitoring روی پایه یک Monitoring قابل اعتماد ساخته میشود.
اگر دادههای اولیه ناقص باشند، مدلهای AI نیز نمیتوانند نتایج قابل اعتمادی تولید کنند.
بهترین معماری معمولاً ترکیبی از این قابلیتهاست:
Monitoring + Observability + Analytics + AI + Automation
مانیتورینگ وضعیت فعلی را مشخص میکند.
Observability به درک علت رفتار سیستم کمک میکند.
AI الگوها و ناهنجاریها را تحلیل میکند.
Predictive Analytics احتمال رخدادهای آینده را بررسی میکند.
و Automation میتواند در صورت وجود Policy مناسب، اقدام لازم را اجرا کند.
چالشهای پیادهسازی Predictive Network Monitoring
با وجود مزایای قابلتوجه، این فناوری بدون چالش نیست.
کیفیت داده
مدلهای AI به دادههای باکیفیت و کافی نیاز دارند.
False Positives
اگر مدل بهدرستی Training یا Tuning نشده باشد، ممکن است هشدارهای غیرضروری تولید کند.
Integration
اتصال تجهیزات و سیستمهای مختلف سازمان به یک Platform مشترک میتواند پیچیده باشد.
Explainability
تیم IT باید بتواند بفهمد چرا سیستم یک رفتار را Anomaly تشخیص داده است.
امنیت داده
Telemetry شبکه میتواند حاوی اطلاعات حساس درباره زیرساخت سازمان باشد و باید بهدرستی محافظت شود.
بنابراین AI نباید یک Black Box باشد.
برای استفاده سازمانی، تیمهای IT باید بتوانند منطق هشدار، دادههای مورد استفاده و سطح اطمینان Prediction را تا حد مناسبی مشاهده کنند.
آینده مانیتورینگ شبکه؛ از Reactive به Predictive
آینده Network Operations فقط درباره جمعآوری Metric بیشتر نیست.
تمرکز اصلی به سمت ایجاد سیستمهایی حرکت میکند که بتوانند:
See → Understand → Predict → Act
یعنی:
- وضعیت زیرساخت را مشاهده کنند.
- روابط میان رخدادها را درک کنند.
- احتمال مشکلات آینده را پیشبینی کنند.
- در چارچوب Policyهای مشخص، اقدام مناسب انجام دهند.
این تغییر میتواند نقش تیمهای NOC و Infrastructure را نیز متحول کند.
در مدل سنتی، بخش قابلتوجهی از زمان کارشناسان صرف بررسی Alertها میشود.
در مدل هوشمند، تمرکز بیشتر روی تحلیل، تصمیمگیری، بهینهسازی و پیشگیری قرار میگیرد.
جمعبندی
Predictive Network Monitoring یکی از مسیرهای مهم تحول Network Operations و IT Infrastructure Management است.
ترکیب AI، Machine Learning، Network Telemetry، Anomaly Detection، Predictive Analytics، Observability و AIOps میتواند به سازمانها کمک کند تا از مدیریت واکنشی زیرساخت فاصله بگیرند.
اما ارزش واقعی این فناوری صرفاً در «پیشبینی خرابی» نیست.
ارزش اصلی زمانی ایجاد میشود که دادههای پراکنده زیرساخت به Insight قابل اقدام تبدیل شوند.
یک سیستم هوشمند Monitoring باید بتواند به جای اینکه فقط بگوید:
“Something is wrong.”
به تیم IT کمک کند بفهمد:
What changed? Why did it change? What is likely to happen next? And what should we do now?
همین تغییر از Reactive Monitoring به Predictive Infrastructure Management میتواند یکی از مهمترین گامها در مسیر ساخت زیرساختهای resilient، automated و intelligent باشد.
سوالات متداول درباره Predictive Network Monitoring
Predictive Network Monitoring چیست؟
Predictive Network Monitoring رویکردی مبتنی بر AI و Machine Learning است که با تحلیل دادههای فعلی و تاریخی شبکه، الگوهای غیرعادی و احتمال وقوع مشکلات آینده را شناسایی میکند.
تفاوت Predictive Monitoring با Network Monitoring چیست؟
Network Monitoring معمولاً وضعیت فعلی شبکه را بررسی و مشکلات موجود را شناسایی میکند؛ در حالی که Predictive Monitoring علاوه بر وضعیت فعلی، روندها و الگوهای تاریخی را تحلیل میکند تا مشکلات احتمالی آینده را پیشبینی کند.
آیا Predictive Network Monitoring از هوش مصنوعی استفاده میکند؟
بله. بسیاری از سیستمهای Predictive Monitoring از Machine Learning، Anomaly Detection، Behavioral Analytics و AIOps برای تحلیل دادههای شبکه استفاده میکنند.
Predictive Network Monitoring چه مزیتی برای سازمان دارد؟
کاهش Downtime، کاهش MTTR، تشخیص زودهنگام مشکلات، کاهش Alert Fatigue، بهبود Capacity Planning و افزایش Visibility از مهمترین مزایای آن هستند.
آیا Predictive Monitoring برای Hybrid Cloud مناسب است؟
بله. یکی از کاربردهای مهم آن، تحلیل همزمان دادههای شبکه، دیتاسنتر، Cloud، Virtualization و Application در محیطهای Hybrid است.
آیا AI میتواند جایگزین Network Engineers شود؟
خیر. هدف اصلی AI در Network Operations، افزایش توان کارشناسان، کاهش کارهای تکراری، تحلیل حجم بالای داده و کمک به تصمیمگیری است. تصمیمهای حساس همچنان باید تحت کنترل و Governance انسانی قرار داشته باشند.
خدمات RootNet در حوزه مانیتورینگ هوشمند زیرساخت
پیادهسازی Predictive Network Monitoring فقط به انتخاب یک ابزار محدود نمیشود. طراحی معماری مانیتورینگ، جمعآوری و یکپارچهسازی Telemetry، اتصال تجهیزات شبکه و سرورها، تعریف Baseline، تنظیم Alertها، پیادهسازی Observability و ایجاد فرآیندهای هوشمند برای تحلیل و واکنش، همگی نیازمند طراحی و اجرای صحیح هستند.
تیم RootNet میتواند در این مسیر به سازمانها کمک کند؛ از طراحی و پیادهسازی Network Monitoring و Infrastructure Monitoring تا Observability، تحلیل دادههای زیرساخت، AIOps، مانیتورینگ سرورها و شبکه، بهینهسازی Performance و توسعه فرآیندهای Proactive Monitoring.
هدف RootNet این است که Monitoring را از یک سیستم صرفاً هشداردهنده، به یک قابلیت عملیاتی برای کاهش Downtime، بهبود Performance و تصمیمگیری هوشمندانهتر درباره زیرساخت تبدیل کند.
آینده شبکههای هوشمند
با افزایش پیچیدگی زیرساختهای Enterprise، سازمانها دیگر نمیتوانند صرفاً به هشدارهای Threshold-based متکی باشند.
نسل بعدی Network Operations به سمت سیستمهایی حرکت میکند که بتوانند مشاهده کنند، تحلیل کنند، پیشبینی کنند و در نهایت به شکل کنترلشده اقدام کنند.
Predictive Network Monitoring یکی از فناوریهایی است که این مسیر را از Monitoring به Intelligent Infrastructure Operations نزدیکتر میکند.
دیدگاه ها بسته هستند