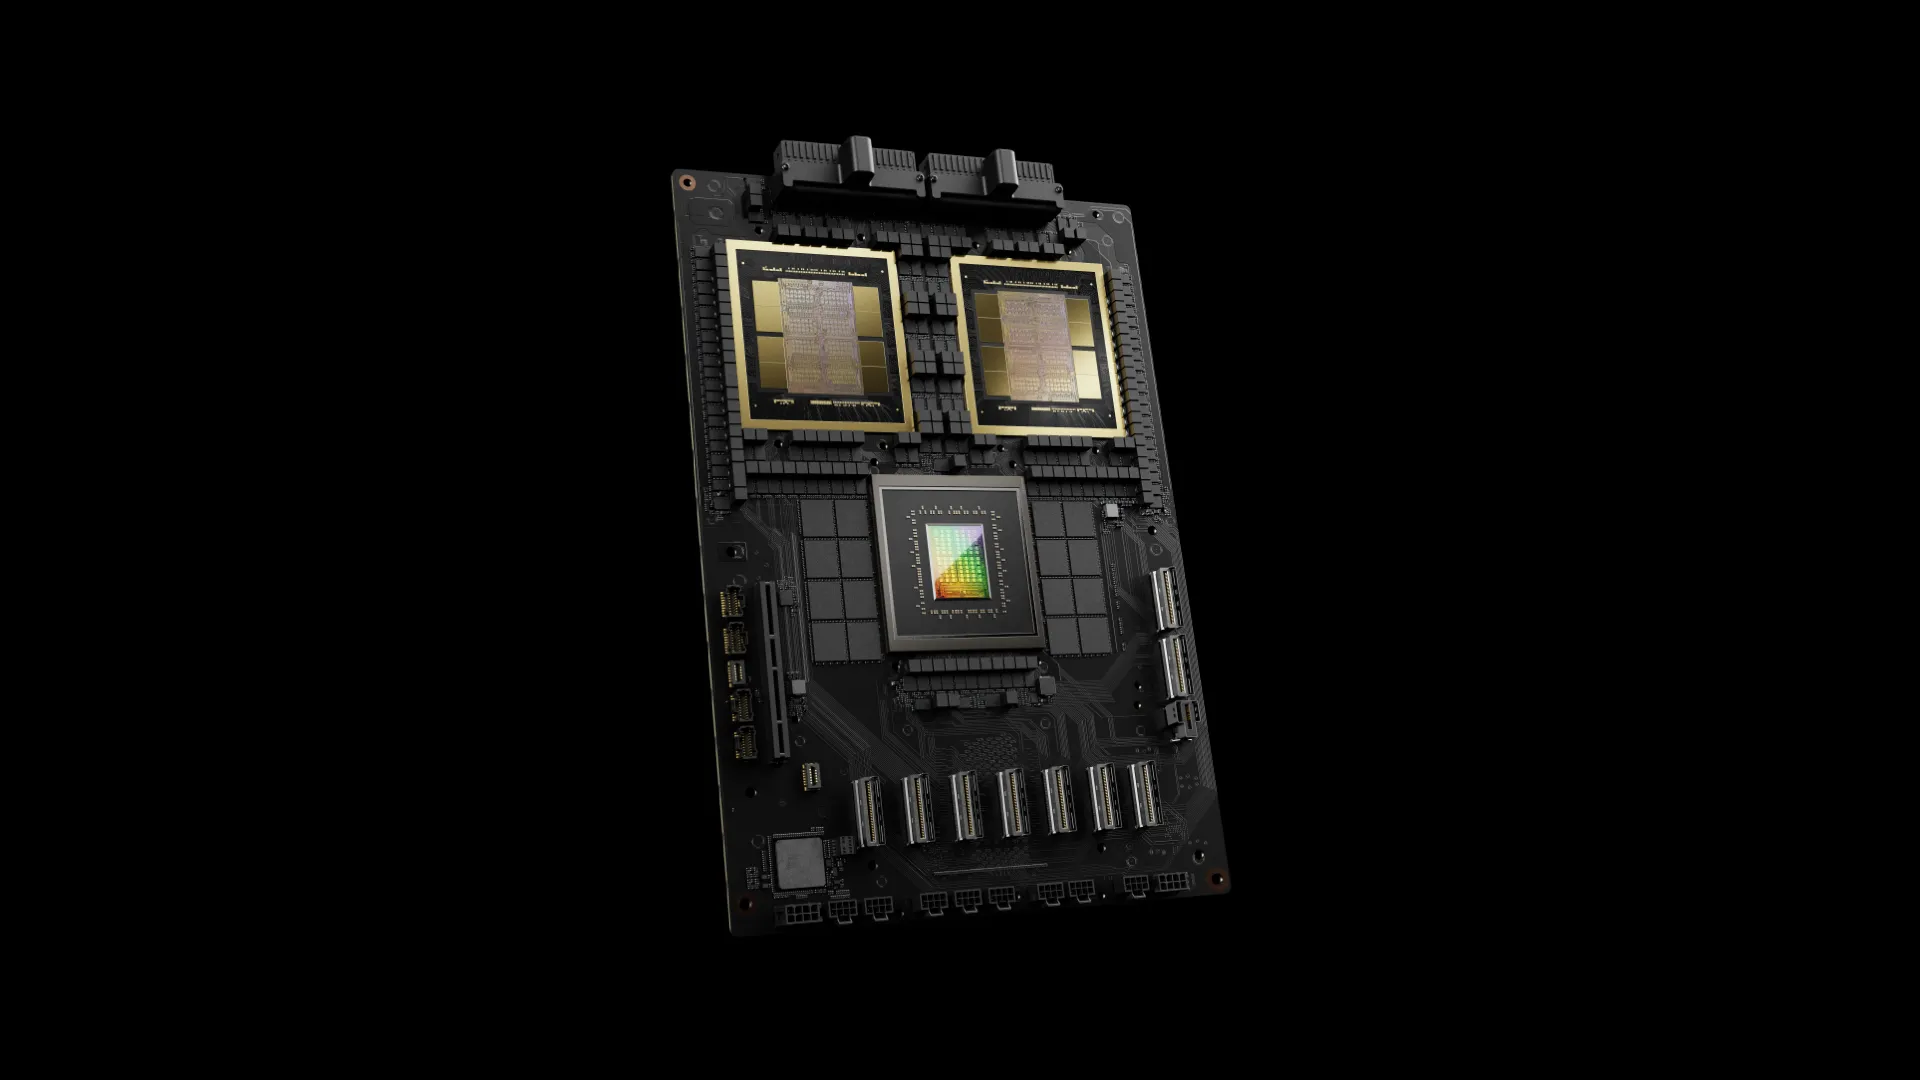
GTC 2024 – انویدیا (Nvidia) در رویداد GTC ۲۰۲۴، بمب جدیدی را منفجر کرد: GPU Blackwell B200، جانشین قدرتمند Hopper H100. این GPU جدید با تمرکز بر هوش مصنوعی (AI) و محاسبات دادهمحور، بیش از ۴ برابر عملکرد Hopper را ارائه میدهد و آینده سوپرکامپیوترهای AI را تغییر میدهد. اگر به دنبال جزئیات Nvidia Blackwell هستید، این مقاله همه چیز را پوشش میدهد – از مشخصات فنی تا تأثیر آن بر صنعت AI.
چرا Blackwell B200 یک جهش عظیم است؟
انویدیا با Blackwell B200، مرزهای محاسبات AI را جابهجا کرده است. این GPU با ۲۰۸ میلیارد ترانزیستور (بیش از دو برابر H100 با ۸۰ میلیارد ترانزیستور)، ۲۰ پتافلاپس عملکرد AI در فرمت FP4 ارائه میدهد – در حالی که H100 تنها ۴ پتافلاپس داشت. این یعنی 4X افزایش سرعت در آموزش و استنتاج مدلهای بزرگ AI.
علاوه بر این، B200 از ۱۹۲ گیگابایت حافظه HBM3e با پهنای باند ۸ ترابایت بر ثانیه بهره میبرد. اما نکته جالب: این GPU تکچیپ نیست! دو die به هم متصل با رابط NV-HBI ۱۰ ترابایت بر ثانیه، یک GPU واحد CUDA میسازند. این طراحی به دلیل محدودیتهای فرآیند TSMC 4NP (نسخه بهبودیافته 4N Hopper) انتخاب شده و اجازه میدهد تا بدون افزایش چشمگیر اندازه die، قدرت بیشتری بسازیم.
مشخصات کلیدی GPU Blackwell B200 و مقایسه با Hopper H100
برای درک بهتر، جدول زیر عملکرد B200 را با H100 مقایسه میکند (با تمرکز بر فرمتهای رایج AI). توجه: اعداد با sparsity (فشردهسازی) محاسبه شدهاند و بدون آن نصف میشوند.
| فرمت محاسباتی | Blackwell B200 (پتافلاپس) | Hopper H100 (پتافلاپس) | افزایش عملکرد |
|---|---|---|---|
| FP4 Tensor | 20 (Dense) / 40 (Sparse) | – | 5X+ (جدید) |
| FP8/FP6 Tensor | 10 / 20 | 4 / 8 | 2.5X |
| FP16/BF16 Tensor | 5 / 10 | 2 / 4 | 2.5X |
| TF32 Tensor | 2.5 / 5 | 1 / 2 | 2.5X |
| FP64 Tensor (Dense) | 0.045 (45 TFLOPS) | 0.06 (60 TFLOPS) | ۰.75X (کاهش برای تمرکز روی AI) |
| حافظه | 192GB HBM3e | 80GB HBM3 (H200: 141GB) | 2.4X |
| پهنای باند | 8 TB/s | 3.35 TB/s | 2.4X |
| مصرف برق (TDP) | 1000W | 700W | 1.4X |
نکته مهم: B200 از فرمت جدید FP4 (دو برابر سریعتر از FP8) و FP6 (برای دقت متوسط) پشتیبانی میکند. موتور Transformer Engine نسل دوم انویدیا، مدلها را به طور خودکار بهینه میکند تا حداکثر سرعت را بگیرید.
سوپرخپ GB200: ترکیب Grace CPU و دو B200 GPU
انویدیا فقط GPU نساخت؛ Grace Blackwell GB200 سوپرخپ را معرفی کرد که یک Grace CPU را با دو B200 GPU جفت میکند. این ترکیب:
- 384GB حافظه با ۱۶ TB/s پهنای باند.
- تا 2700W TDP (1200W برای هر GPU + 300W CPU).
- ۴۰ پتافلاپس FP4 (دو برابر B200 تک).
این سوپرخپ برای مدلهای “Mixture of Experts” (MoE) ایدهآل است و عملکرد FP64 را به ۹۰ TFLOPS میرساند.
NVLink ۵ و NVSwitch: حل bottleneck ارتباطات
در workloads AI بزرگ، ارتباطات بین GPUها تا ۶۰% زمان را میگیرد. انویدیا با NVLink نسل ۵ و NVSwitch ۷.2T این مشکل را حل کرد:
- هر B200: ۱۸ لینک NVLink با ۱۰۰ GB/s دوطرفه (18X بیشتر از H100).
- NVSwitch: ۱.۸ TB/s bandwidth، پشتیبانی از ۵۷۶ GPU، و ۳.۶ TFLOPS Sharp v4 برای پردازش in-network.
- افزایش 18X سرعت interconnect نسبت به Hopper.
سیستمهای بزرگ: NVL72 و SuperPOD
- GB200 NVL72: رک کامل با ۷۲ B200 GPU و ۳۶ Grace CPU. ۱۴۴۰ پتافلاپس FP4، ۱۳۰ TB/s bandwidth، و پشتیبانی از مدلهای ۲۷ تریلیون پارامتر. (مقایسه: 4X آموزش سریعتر و 30X استنتاج سریعتر از H100).
- SuperPOD: تا ۵۷۶ GPU (۸ NVL72)، ۱۱.۵ اگزافلاپس FP4، و مقیاسپذیری به هزاران GPU. مثالی از ۵۶ SuperPOD: ۶۴۵ اگزافلاپس و 13PB حافظه!
انویدیا با AWS، Google Cloud و Oracle همکاری میکند تا این سیستمها را در ابر عرضه کند – مانند Project Ceiba با ۲۰,۰۰۰+ B200 GPU.
Blackwell B100: نسخه سازگار با H100
برای مهاجرت آسان، B100 با TDP 700W (مانند H100) و ۱۴ پتافلاپس FP4 عرضه میشود. HGX B100 (۸ GPU) مستقیماً جایگزین HGX H100 است.
آینده Blackwell: تولید و رقابت
تولید B200 از اواخر ۲۰۲۴ شروع میشود. قیمت؟ H100 حدود ۴۰,۰۰۰ دلار است، پس B200 ممکن است به ۱۰۰,۰۰۰ دلار برسد – اما ارزشش را دارد! انویدیا با تمرکز ۱۰ ساله روی AI، رقبا را پشت سر گذاشته (رشد ۱۲۶% درآمد دادهسنتر).
سؤالهای متداول (FAQ):
- Blackwell برای مصرفکننده میآید؟ احتمالاً در ۲۰۲۵، اما متفاوت از نسخه دادهسنتر.
- بهبود انرژی؟ تا 25X کارایی بهتر نسبت به H100 در مدلهای بزرگ.
- رقابت با AMD/Intel؟ انویدیا فعلاً پیشتاز است، اما رقبا در حال تعقیباند.
دیدگاه ها بسته هستند