مانیتورینگ ماشینهای مجازی (Virtual Machine Monitoring) چیست و چرا برای زیرساختهای مدرن حیاتی است؟
مقدمه
در سالهای اخیر، فناوری مجازیسازی (Virtualization) به یکی از مهمترین ارکان زیرساختهای فناوری اطلاعات تبدیل شده است. سازمانهای کوچک و بزرگ، شرکتهای ارائهدهنده خدمات ابری، دیتاسنترها و حتی بسیاری از کسبوکارهای متوسط، برای کاهش هزینهها، افزایش بهرهوری و مدیریت بهتر منابع، از ماشینهای مجازی (Virtual Machines یا VM) استفاده میکنند. امروزه اجرای دهها یا حتی صدها سرور مجازی روی یک سرور فیزیکی، به یک استاندارد رایج در مراکز داده تبدیل شده است.
با وجود مزایای فراوان مجازیسازی، مدیریت صحیح این زیرساخت بدون مانیتورینگ امکانپذیر نیست. افزایش مصرف پردازنده، کمبود حافظه، اختلال در ذخیرهسازها، مشکلات شبکه، خرابی Hypervisor یا حتی اجرای یک فرآیند غیرعادی میتواند عملکرد چندین سرویس حیاتی را بهطور همزمان تحت تأثیر قرار دهد. اگر این مشکلات بهموقع شناسایی نشوند، ممکن است باعث کاهش سرعت سرویسها، از دسترس خارج شدن برنامههای کاربردی، نارضایتی کاربران و تحمیل هزینههای سنگین به سازمان شوند.
به همین دلیل، مانیتورینگ ماشینهای مجازی (Virtual Machine Monitoring) یکی از مهمترین بخشهای مدیریت زیرساختهای مدرن محسوب میشود. یک سامانه مانیتورینگ حرفهای با پایش مداوم منابع، تحلیل دادههای عملکردی و ارسال هشدارهای هوشمند، به مدیران شبکه کمک میکند مشکلات را پیش از تبدیل شدن به بحران شناسایی و برطرف کنند.
در این مقاله بهصورت جامع با مفاهیم مانیتورینگ ماشینهای مجازی، شاخصهای مهم، ابزارهای مورد استفاده، روشهای بهینه، نکات امنیتی و بهترین راهکارهای مدیریت زیرساختهای مجازی آشنا خواهید شد.
ماشین مجازی (Virtual Machine) چیست؟
ماشین مجازی یا Virtual Machine محیطی نرمافزاری است که عملکرد یک رایانه فیزیکی را شبیهسازی میکند. هر ماشین مجازی دارای سیستمعامل، پردازنده مجازی (vCPU)، حافظه (vRAM)، کارت شبکه مجازی و فضای ذخیرهسازی اختصاصی است و مانند یک سرور مستقل عمل میکند.
برخلاف سرورهای فیزیکی، چندین ماشین مجازی میتوانند بهطور همزمان روی یک سرور فیزیکی اجرا شوند. این موضوع باعث استفاده بهینه از منابع سختافزاری، کاهش هزینهها و سادهتر شدن مدیریت زیرساخت میشود.
امروزه بسیاری از سرویسهای مهم مانند وبسرورها، پایگاههای داده، سرورهای ایمیل، سیستمهای ERP، نرمافزارهای مالی و حتی تجهیزات امنیتی بهصورت ماشین مجازی اجرا میشوند.
Hypervisor چیست؟
Hypervisor نرمافزاری است که وظیفه ایجاد، مدیریت و اجرای ماشینهای مجازی را بر عهده دارد. این لایه بین سختافزار و ماشینهای مجازی قرار میگیرد و منابع فیزیکی را بین VMها تقسیم میکند.
Hypervisorها به دو دسته اصلی تقسیم میشوند:
Type 1 Hypervisor
این نوع مستقیماً روی سختافزار نصب میشود و بیشترین کارایی و امنیت را ارائه میدهد.
نمونهها:
- VMware ESXi
- Microsoft Hyper-V
- Proxmox VE
- Xen
- KVM
Type 2 Hypervisor
این نوع روی سیستمعامل نصب میشود و بیشتر برای محیطهای آزمایشگاهی یا توسعه استفاده میشود.
نمونهها:
- VMware Workstation
- Oracle VirtualBox
- VMware Fusion
در محیطهای سازمانی تقریباً همیشه از Hypervisorهای نوع اول استفاده میشود.
Host و Guest چه تفاوتی دارند؟
در محیطهای مجازی دو اصطلاح بسیار مهم وجود دارد.
Host همان سرور فیزیکی است که ماشینهای مجازی روی آن اجرا میشوند.
Guest سیستمعامل یا ماشین مجازی است که داخل Host اجرا میشود.
برای داشتن یک زیرساخت پایدار باید هم Host و هم Guest بهصورت همزمان مانیتور شوند؛ زیرا ممکن است مشکل از منابع سرور فیزیکی باشد، در حالی که علائم آن داخل ماشین مجازی مشاهده شود.
مانیتورینگ ماشینهای مجازی چیست؟
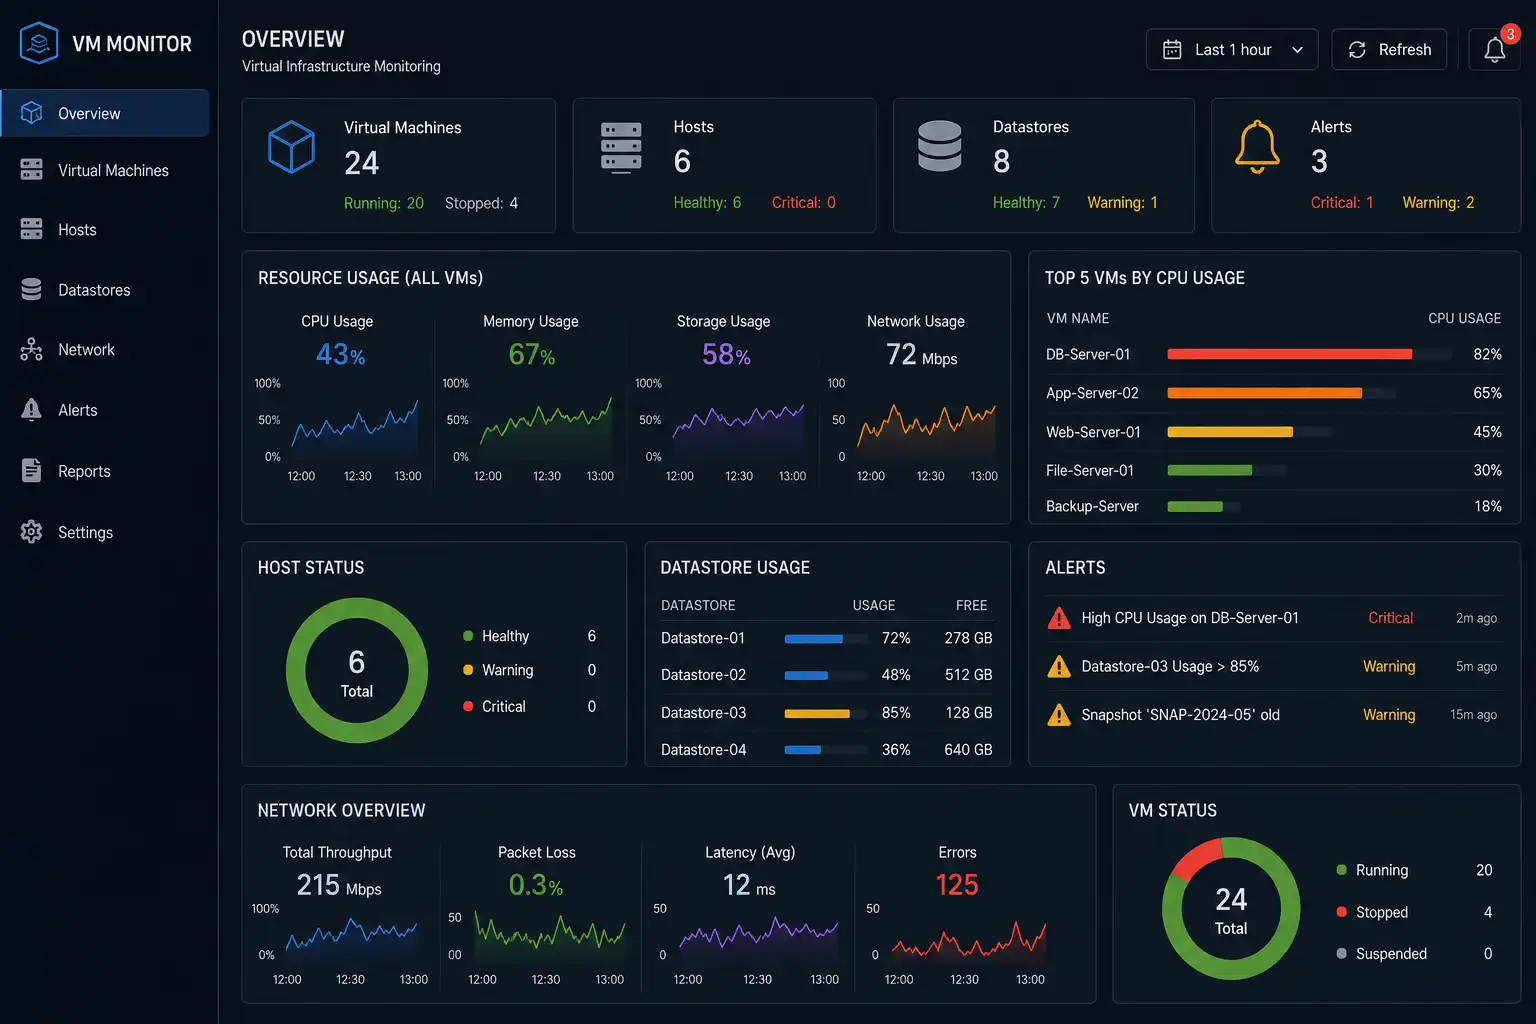
مانیتورینگ ماشینهای مجازی فرآیند جمعآوری، تحلیل و نمایش اطلاعات مربوط به سلامت، عملکرد و مصرف منابع ماشینهای مجازی است.
یک سیستم مانیتورینگ حرفهای بهصورت لحظهای اطلاعاتی مانند مصرف CPU، حافظه، دیسک، شبکه، وضعیت سرویسها، سلامت Hypervisor، رخدادهای سیستمعامل و لاگهای امنیتی را بررسی میکند و در صورت مشاهده هرگونه رفتار غیرعادی، هشدارهای لازم را ارسال میکند.
هدف اصلی مانیتورینگ، پیشگیری از بروز مشکل است؛ نه صرفاً اطلاع از خرابی پس از وقوع آن.
چرا مانیتورینگ ماشینهای مجازی اهمیت دارد؟
در زیرساختهای سنتی، خرابی یک سرور معمولاً فقط همان سرویس را تحت تأثیر قرار میداد. اما در محیطهای مجازی، دهها ماشین مجازی ممکن است روی یک Host اجرا شوند. در نتیجه خرابی یک سرور فیزیکی یا اشباع منابع آن میتواند بهطور همزمان چندین سرویس حیاتی را از دسترس خارج کند.
مانیتورینگ حرفهای ماشینهای مجازی به سازمانها کمک میکند تا:
- از بروز Downtime جلوگیری کنند.
- سلامت ماشینهای مجازی را بهصورت لحظهای مشاهده کنند.
- ظرفیت منابع را مدیریت کنند.
- گلوگاههای عملکرد را شناسایی کنند.
- هزینههای عملیاتی را کاهش دهند.
- امنیت زیرساخت را افزایش دهند.
- مشکلات را قبل از گزارش کاربران برطرف کنند.
- عملکرد سرویسهای حیاتی را بهبود دهند.
- برنامهریزی دقیقتری برای توسعه زیرساخت انجام دهند.
- سطح توافق خدمات (SLA) را حفظ کنند.
مهمترین شاخصهای مانیتورینگ ماشینهای مجازی
یک سامانه مانیتورینگ حرفهای باید دهها شاخص مختلف را بررسی کند. مهمترین آنها عبارتاند از:
مانیتورینگ CPU
پردازنده یکی از حیاتیترین منابع هر ماشین مجازی است. افزایش بیش از حد مصرف CPU میتواند باعث کاهش عملکرد برنامهها، افزایش زمان پاسخ و حتی توقف برخی سرویسها شود.
پارامترهای مهم عبارتاند از:
- CPU Usage
- CPU Ready Time
- CPU Wait
- CPU Load
- تعداد vCPU
- CPU Contention
بهطور معمول، اگر مصرف پردازنده برای مدت طولانی از ۸۵ تا ۹۰ درصد بیشتر باشد، باید علت آن بررسی شود.
مانیتورینگ حافظه (RAM)
حافظه ناکافی یکی از رایجترین دلایل کند شدن ماشینهای مجازی است.
شاخصهای مهم شامل موارد زیر هستند:
- Memory Usage
- Active Memory
- Memory Pressure
- Ballooning
- Swapping
- Free Memory
اگر Hypervisor مجبور به استفاده از Ballooning یا Swapping شود، معمولاً نشاندهنده کمبود منابع حافظه است.
مانیتورینگ فضای ذخیرهسازی
فضای ذخیرهسازی فقط به ظرفیت دیسک محدود نمیشود. سرعت دسترسی به اطلاعات نیز اهمیت بسیار زیادی دارد.
پارامترهای مهم عبارتاند از:
- Disk Usage
- Disk Latency
- IOPS
- Read Speed
- Write Speed
- Queue Length
- Datastore Usage
افزایش Disk Latency یکی از اولین نشانههای کاهش عملکرد ماشین مجازی محسوب میشود.
مانیتورینگ شبکه
ماشینهای مجازی برای ارائه سرویس به ارتباط پایدار شبکه وابسته هستند.
پارامترهای مهم شبکه عبارتاند از:
- Bandwidth Usage
- Packet Loss
- Latency
- Jitter
- Throughput
- Network Errors
- Interface Utilization
افزایش Packet Loss یا Latency میتواند باعث کاهش کیفیت سرویسهای تحت شبکه مانند VoIP، پایگاههای داده و برنامههای ابری شود.
مانیتورینگ سیستمعامل
در کنار منابع سختافزاری، وضعیت سیستمعامل نیز باید بهصورت مستمر بررسی شود.
مهمترین شاخصها عبارتاند از:
- وضعیت سرویسها
- فرآیندهای فعال
- میزان مصرف CPU توسط هر Process
- مصرف حافظه
- کاربران متصل
- Event Log
- Syslog
- Uptime
- وضعیت بهروزرسانیها
- سلامت فایلسیستم
مانیتورینگ Host
سلامت ماشینهای مجازی وابستگی مستقیمی به وضعیت سرور فیزیکی دارد.
در مانیتورینگ Host معمولاً موارد زیر بررسی میشوند:
- دمای پردازنده
- سلامت حافظه
- سلامت RAID
- وضعیت هارددیسکها
- سلامت SSDها
- سرعت فنها
- وضعیت پاور
- سلامت کارت شبکه
- مصرف برق
- سلامت Storage
- سلامت کنترلر RAID
در صورت بروز مشکل در Host، ممکن است تمام ماشینهای مجازی مستقر روی آن با اختلال مواجه شوند.
مانیتورینگ Hypervisor
Hypervisor قلب زیرساخت مجازی است و تمام ماشینهای مجازی برای اجرا به آن وابسته هستند. اگر Hypervisor با مشکل مواجه شود، ممکن است چندین ماشین مجازی بهطور همزمان از دسترس خارج شوند. به همین دلیل، مانیتورینگ Hypervisor باید یکی از مهمترین بخشهای استراتژی مانیتورینگ هر سازمان باشد.
در مانیتورینگ Hypervisor معمولاً شاخصهای زیر بررسی میشوند:
- سلامت Host
- مصرف CPU
- مصرف RAM
- وضعیت Datastore
- ظرفیت Storage
- وضعیت Snapshotها
- تعداد ماشینهای مجازی فعال
- ماشینهای خاموش یا Suspend شده
- وضعیت HA Cluster
- Live Migration
- vMotion
- سلامت کارتهای شبکه
- سلامت کنترلر RAID
- وضعیت License
بررسی مداوم این شاخصها به مدیران شبکه کمک میکند تا مشکلات احتمالی را قبل از تأثیرگذاری بر سرویسهای سازمانی شناسایی کنند.
مانیتورینگ VMware
یکی از رایجترین بسترهای مجازیسازی در سازمانها، VMware است. بسیاری از دیتاسنترهای بزرگ جهان از VMware ESXi و VMware vCenter برای مدیریت ماشینهای مجازی استفاده میکنند.
در محیط VMware تنها مانیتور کردن ماشینهای مجازی کافی نیست، بلکه باید کل زیرساخت بررسی شود.
موارد مهم در مانیتورینگ VMware عبارتاند از:
- سلامت ESXi Host
- مصرف CPU و RAM
- وضعیت Datastore
- سلامت Cluster
- وضعیت HA
- عملکرد DRS
- فرآیندهای vMotion
- Snapshotهای قدیمی
- سلامت Storage
- وضعیت کارتهای شبکه
- سلامت ماشینهای مجازی
- مصرف منابع هر VM
- وضعیت License
یکی از مشکلات رایج در VMware باقی ماندن Snapshotها برای مدت طولانی است. Snapshotهای قدیمی میتوانند فضای Datastore را اشغال کرده و باعث کاهش عملکرد ماشینهای مجازی شوند.
همچنین بررسی مقدار CPU Ready Time اهمیت زیادی دارد. در برخی موارد مصرف CPU پایین است، اما به دلیل اشباع Host، ماشین مجازی مدت زیادی منتظر دریافت پردازنده باقی میماند.
مانیتورینگ Microsoft Hyper-V
Hyper-V یکی از محبوبترین Hypervisorهای سازمانی است که در بسیاری از شرکتها برای اجرای ماشینهای مجازی استفاده میشود.
در مانیتورینگ Hyper-V معمولاً این شاخصها بررسی میشوند:
- سلامت Host
- سلامت Failover Cluster
- وضعیت Live Migration
- سلامت Replica
- مصرف منابع ماشینهای مجازی
- وضعیت Storage
- سلامت Virtual Switch
- وضعیت Backup
- Event Log
- وضعیت Integration Services
در محیطهای مبتنی بر Hyper-V، بررسی وضعیت Failover Cluster اهمیت ویژهای دارد؛ زیرا بروز مشکل در Cluster میتواند فرآیند انتقال خودکار ماشینهای مجازی را مختل کند.
مانیتورینگ Proxmox VE
در سالهای اخیر استفاده از Proxmox VE در سازمانها و شرکتهای ارائهدهنده خدمات میزبانی رشد قابل توجهی داشته است.
Proxmox ترکیبی از فناوری KVM و LXC را ارائه میدهد و امکانات مدیریتی بسیار مناسبی در اختیار مدیران شبکه قرار میدهد.
در مانیتورینگ Proxmox معمولاً موارد زیر بررسی میشوند:
- سلامت Node
- وضعیت Cluster
- مصرف CPU
- مصرف RAM
- وضعیت Ceph
- سلامت Storage
- وضعیت Backup
- Snapshotها
- سلامت Containerها
- سلامت ماشینهای مجازی
- وضعیت Replication
در زیرساختهای مبتنی بر Ceph، بررسی وضعیت OSDها و سلامت Cluster اهمیت بسیار زیادی دارد؛ زیرا هرگونه اختلال در Ceph مستقیماً روی عملکرد ماشینهای مجازی تأثیر میگذارد.
مانیتورینگ KVM
KVM یکی از قدرتمندترین Hypervisorهای متنباز محسوب میشود و در بسیاری از محیطهای لینوکسی مورد استفاده قرار میگیرد.
در مانیتورینگ KVM معمولاً این شاخصها بررسی میشوند:
- مصرف CPU
- مصرف RAM
- سلامت ماشینهای مجازی
- وضعیت شبکه
- مصرف دیسک
- سلامت Host
- وضعیت Storage
- عملکرد libvirt
- سلامت Bridgeهای شبکه
از آنجا که KVM معمولاً در محیطهای لینوکسی استفاده میشود، بررسی لاگهای سیستم نیز اهمیت ویژهای دارد.
ابزارهای مانیتورینگ ماشینهای مجازی
امروزه ابزارهای متعددی برای مانیتورینگ ماشینهای مجازی وجود دارند. انتخاب ابزار مناسب به اندازه زیرساخت، بودجه، نیازهای سازمان و نوع Hypervisor بستگی دارد.
برخی از محبوبترین ابزارها عبارتاند از:
- Splunk
- Zabbix
- Grafana
- Prometheus
- PRTG Network Monitor
- Nagios
- SolarWinds
- ManageEngine OpManager
- VMware vCenter
- Microsoft System Center Operations Manager
هر یک از این ابزارها قابلیتهای متفاوتی ارائه میکنند. برخی بر تحلیل Logها تمرکز دارند، برخی برای جمعآوری Metrics طراحی شدهاند و برخی نیز راهکار جامعی برای مانیتورینگ زیرساخت ارائه میدهند.
مقایسه ابزارهای مانیتورینگ
| ابزار | مناسب برای | مزیت اصلی |
|---|---|---|
| Splunk | تحلیل Log و امنیت | جستجوی قدرتمند و داشبوردهای حرفهای |
| Zabbix | مانیتورینگ کامل زیرساخت | متنباز و انعطافپذیر |
| Grafana | نمایش داشبورد | مصورسازی حرفهای دادهها |
| Prometheus | جمعآوری Metrics | مناسب Kubernetes و Cloud |
| PRTG | شبکه و سرور | نصب و راهاندازی آسان |
| SolarWinds | سازمانهای بزرگ | گزارشگیری پیشرفته |
| VMware vCenter | محیط VMware | مدیریت و مانیتورینگ یکپارچه |
مهمترین هشدارهایی که باید تعریف شوند
تعریف Alert مناسب باعث میشود تیم فناوری اطلاعات قبل از ایجاد اختلال از مشکل مطلع شود.
هشدارهای مهم عبارتاند از:
- مصرف CPU بیشتر از ۹۰ درصد
- مصرف RAM بیشتر از ۸۵ درصد
- Disk Usage بیشتر از ۸۵ درصد
- افزایش Disk Latency
- افزایش Packet Loss
- خاموش شدن ماشین مجازی
- قطع ارتباط Host
- کاهش فضای Datastore
- خرابی RAID
- خرابی Storage
- افزایش دمای سرور
- توقف سرویسهای حیاتی
- عدم موفقیت در Backup
- ایجاد Snapshot جدید
- باقی ماندن Snapshot بیش از مدت تعیینشده
سناریوی اول: افزایش ناگهانی مصرف CPU
فرض کنید یکی از ماشینهای مجازی که میزبان یک پایگاه داده است، ناگهان مصرف CPU آن به ۱۰۰ درصد میرسد.
اگر سیستم مانیتورینگ بهدرستی تنظیم شده باشد، بلافاصله هشدار صادر میشود.
مدیر سیستم میتواند موارد زیر را بررسی کند:
- آیا پردازش جدیدی اجرا شده است؟
- آیا حملهای به سرور انجام شده است؟
- آیا Queryهای پایگاه داده افزایش یافتهاند؟
- آیا منابع ماشین مجازی کافی هستند؟
- آیا Host دچار اشباع شده است؟
در بسیاری از موارد، تشخیص سریع این وضعیت از توقف سرویس جلوگیری میکند.
سناریوی دوم: پر شدن Datastore
پر شدن فضای Datastore یکی از مشکلات رایج در VMware است.
اگر فضای Datastore به پایان برسد، ممکن است:
- Snapshotها ایجاد نشوند.
- ماشینهای مجازی خاموش شوند.
- عملیات Backup با خطا مواجه شود.
- امکان ایجاد ماشین مجازی جدید وجود نداشته باشد.
به همین دلیل، باید برای ظرفیت Datastore هشدارهای مناسبی تعریف شود.
سناریوی سوم: باقی ماندن Snapshotهای قدیمی
گاهی Snapshot برای انجام یک بهروزرسانی ایجاد میشود اما پس از پایان عملیات حذف نمیشود.
در صورت باقی ماندن Snapshot:
- حجم Datastore افزایش مییابد.
- سرعت ماشین مجازی کاهش پیدا میکند.
- عملیات Backup طولانیتر میشود.
- احتمال پر شدن Storage افزایش پیدا میکند.
یک سیستم مانیتورینگ مناسب باید Snapshotهای قدیمی را شناسایی و به مدیر سیستم اطلاع دهد.
سناریوی چهارم: افزایش Packet Loss
افزایش Packet Loss میتواند باعث اختلال در سرویسهایی مانند:
- VoIP
- پایگاه داده
- Remote Desktop
- ارتباط بین ماشینهای مجازی
- سرویسهای ابری
شود.
در این شرایط باید وضعیت کارت شبکه، سوئیچ، لینکهای ارتباطی و پهنای باند بررسی شود.
بهترین روشهای مانیتورینگ ماشینهای مجازی
برای داشتن یک زیرساخت پایدار، رعایت این اصول توصیه میشود:
- مانیتورینگ همزمان Host و Guest
- تعریف Baseline برای تمام منابع
- استفاده از داشبوردهای اختصاصی
- تعریف Alertهای هوشمند
- بررسی روند مصرف منابع
- نگهداری دادههای تاریخی
- بررسی سلامت Backup
- مانیتورینگ Storage
- بررسی Snapshotها
- مانیتورینگ شبکه
- تحلیل Logها
- انجام Capacity Planning
- بازبینی دورهای Thresholdها
- مستندسازی هشدارها
- آزمایش دورهای فرآیندهای Disaster Recovery
نقش مانیتورینگ در امنیت ماشینهای مجازی
بسیاری از مدیران شبکه تصور میکنند که مانیتورینگ تنها برای بررسی عملکرد و مصرف منابع استفاده میشود، در حالی که یکی از مهمترین کاربردهای آن، افزایش امنیت زیرساختهای مجازی است. ماشینهای مجازی میزبان بسیاری از سرویسهای حیاتی سازمان مانند پایگاههای داده، وبسرورها، سرورهای ایمیل، سامانههای مالی و نرمافزارهای سازمانی هستند. هرگونه فعالیت غیرعادی در این ماشینها میتواند نشانهای از یک حمله سایبری یا نقص امنیتی باشد.
یک سامانه مانیتورینگ حرفهای با تحلیل مداوم شاخصهای عملکرد، لاگهای سیستم و رفتار کاربران، میتواند بسیاری از تهدیدات را در مراحل اولیه شناسایی کند و از تبدیل آنها به یک حادثه امنیتی جلوگیری کند.
مواردی که با مانیتورینگ قابل شناسایی هستند عبارتاند از:
- افزایش ناگهانی مصرف CPU توسط بدافزارها
- حملات Brute Force به سرورها
- مصرف غیرعادی حافظه
- افزایش غیرطبیعی ترافیک شبکه
- اجرای فرآیندهای ناشناس
- تغییرات غیرمجاز در فایلهای سیستمی
- ورودهای ناموفق مکرر کاربران
- استخراج غیرمجاز رمزارز (Cryptojacking)
- انتقال حجم زیاد اطلاعات به خارج از سازمان
- توقف ناگهانی سرویسهای امنیتی
ترکیب مانیتورینگ با سیستمهای مدیریت لاگ و SIEM میتواند دید بسیار دقیقتری نسبت به وضعیت امنیتی زیرساخت ایجاد کند و زمان شناسایی تهدیدات را به میزان قابلتوجهی کاهش دهد.
اشتباهات رایج در مانیتورینگ ماشینهای مجازی
بسیاری از سازمانها ابزار مانیتورینگ را نصب میکنند، اما به دلیل پیادهسازی نادرست، همچنان با مشکلات متعدد روبهرو هستند. آشنایی با این اشتباهات میتواند از بروز بسیاری از مشکلات جلوگیری کند.
۱. مانیتور نکردن سرور میزبان (Host)
برخی مدیران تنها وضعیت ماشینهای مجازی را بررسی میکنند و سلامت سرور فیزیکی را نادیده میگیرند، در حالی که مشکلات Host مستقیماً بر تمام ماشینهای مجازی تأثیر میگذارد.
۲. تعریف بیش از حد هشدارها
تعداد زیاد هشدارها باعث پدیده Alert Fatigue میشود؛ یعنی کارشناسان به دلیل دریافت هشدارهای متعدد، هشدارهای مهم را نیز نادیده میگیرند.
۳. نداشتن Baseline
بدون تعیین مقدار طبیعی مصرف منابع، تشخیص رفتار غیرعادی بسیار دشوار خواهد بود.
۴. بررسی نکردن Snapshotهای قدیمی
Snapshotهایی که برای مدت طولانی حذف نمیشوند، علاوه بر اشغال فضای ذخیرهسازی، عملکرد ماشینهای مجازی را نیز کاهش میدهند.
۵. مانیتور نکردن Storage
بسیاری از مشکلات عملکردی ماشینهای مجازی از Storage ناشی میشوند، نه از CPU یا RAM.
۶. تحلیل نکردن دادههای تاریخی
نگهداری دادههای گذشته امکان پیشبینی رشد مصرف منابع و برنامهریزی برای توسعه زیرساخت را فراهم میکند.
۷. مانیتور نکردن شبکه
گاهی مشکل اصلی از سوئیچ، روتر یا لینک ارتباطی است، نه از خود ماشین مجازی.
۸. استفاده از Thresholdهای نامناسب
تنظیم مقادیر هشدار بدون توجه به نوع سرویس، باعث ایجاد هشدارهای اشتباه یا از دست رفتن هشدارهای مهم میشود.
۹. بررسی نکردن لاگها
لاگهای سیستمعامل، Hypervisor و نرمافزارهای کاربردی اطلاعات ارزشمندی درباره مشکلات و رخدادهای امنیتی ارائه میکنند.
۱۰. تست نکردن هشدارها
تعریف Alert بدون آزمایش عملی ممکن است باعث شود هنگام وقوع حادثه، هیچ هشداری ارسال نشود.
آینده مانیتورینگ ماشینهای مجازی
مانیتورینگ زیرساختها در سالهای اخیر تغییرات چشمگیری داشته است. ابزارهای سنتی که تنها دادهها را نمایش میدادند، جای خود را به سامانههای هوشمند دادهاند که علاوه بر جمعآوری اطلاعات، توانایی تحلیل و پیشبینی مشکلات را نیز دارند.
مهمترین روندهای آینده عبارتاند از:
- استفاده از هوش مصنوعی (AI)
- AIOps
- یادگیری ماشین (Machine Learning)
- تحلیل خودکار Logها
- تشخیص ناهنجاری (Anomaly Detection)
- پیشبینی خرابی تجهیزات
- تحلیل خودکار علت اصلی مشکل (Root Cause Analysis)
- پیشنهاد راهکار برای رفع خطا
- خودکارسازی عملیات (Automation)
این فناوریها به تیمهای فناوری اطلاعات کمک میکنند تا به جای واکنش پس از وقوع مشکل، از وقوع بسیاری از مشکلات جلوگیری کنند.
سؤالات متداول FAQ
مانیتورینگ ماشینهای مجازی چیست؟
مانیتورینگ ماشینهای مجازی فرآیند پایش مداوم سلامت، عملکرد، مصرف منابع و وضعیت سرویسهای اجراشده روی ماشینهای مجازی است تا مشکلات پیش از ایجاد اختلال شناسایی شوند.
مهمترین مزیت مانیتورینگ VM چیست؟
کاهش Downtime، افزایش دسترسپذیری سرویسها، بهینهسازی مصرف منابع، افزایش امنیت و تشخیص سریع مشکلات از مهمترین مزایای مانیتورینگ ماشینهای مجازی هستند.
چه منابعی باید در ماشینهای مجازی مانیتور شوند؟
CPU، حافظه، فضای ذخیرهسازی، شبکه، سیستمعامل، Hypervisor، Host، سرویسها، لاگها و وضعیت Backup از مهمترین بخشهایی هستند که باید پایش شوند.
بهترین ابزارهای مانیتورینگ ماشینهای مجازی کداماند؟
ابزارهایی مانند Splunk، Zabbix، Grafana، Prometheus، PRTG، VMware vCenter، SolarWinds، Nagios و ManageEngine OpManager از محبوبترین راهکارهای مانیتورینگ هستند.
تفاوت مانیتورینگ Host و Guest چیست؟
مانیتورینگ Host سلامت سرور فیزیکی و Hypervisor را بررسی میکند، در حالی که مانیتورینگ Guest بر وضعیت سیستمعامل، سرویسها و منابع مصرفی داخل ماشین مجازی تمرکز دارد.
آیا مانیتورینگ باعث افزایش امنیت میشود؟
بله. بسیاری از فعالیتهای مشکوک مانند حملات Brute Force، بدافزارها، افزایش غیرعادی مصرف منابع و رفتارهای غیرمجاز از طریق مانیتورینگ قابل شناسایی هستند.
چرا Disk Latency اهمیت زیادی دارد؟
زیرا افزایش تأخیر در ذخیرهسازی معمولاً باعث کاهش عملکرد پایگاههای داده، ماشینهای مجازی و سرویسهای حساس به زمان میشود.
Snapshotهای قدیمی چه مشکلی ایجاد میکنند؟
آنها فضای Datastore را اشغال کرده، عملکرد ماشینهای مجازی را کاهش میدهند و فرآیند Backup را با مشکل مواجه میکنند.
Baseline در مانیتورینگ چیست؟
Baseline مقدار طبیعی مصرف منابع در شرایط عادی است که به مدیران شبکه کمک میکند رفتارهای غیرعادی را سریعتر تشخیص دهند.
AIOps چه تأثیری بر مانیتورینگ دارد؟
AIOps با استفاده از هوش مصنوعی، تحلیل دادهها و یادگیری ماشین، مشکلات را پیشبینی کرده و فرآیند تشخیص و رفع خطا را هوشمندتر میکند.
چرا سازمانها روت نت را برای مانیتورینگ زیرساخت انتخاب میکنند؟
- پیادهسازی پروژههای مانیتورینگ از صفر تا صد
- طراحی داشبوردهای اختصاصی
- نصب و پیکربندی Splunk، Zabbix و Grafana
- مانیتورینگ VMware، Hyper-V، Proxmox و KVM
- مانیتورینگ تجهیزات شبکه، سرورها و سرویسها
- تحلیل لاگ و رخدادهای امنیتی (SIEM)
- آموزش و انتقال دانش به تیم فناوری اطلاعات مشتری
- پشتیبانی و بهینهسازی مستمر
جمعبندی
ماشینهای مجازی به بخش جداییناپذیر زیرساختهای فناوری اطلاعات تبدیل شدهاند و امروزه بخش بزرگی از سرویسهای حیاتی سازمانها روی بسترهای مجازی اجرا میشوند. در چنین شرایطی، مانیتورینگ ماشینهای مجازی دیگر یک قابلیت اختیاری نیست، بلکه یکی از الزامات اصلی مدیریت زیرساخت به شمار میرود.
یک سامانه مانیتورینگ حرفهای با پایش مستمر منابع پردازشی، حافظه، شبکه، ذخیرهسازی، Hypervisor و سیستمعامل، امکان شناسایی سریع مشکلات، بهینهسازی مصرف منابع، کاهش Downtime، افزایش امنیت و برنامهریزی دقیق برای توسعه زیرساخت را فراهم میکند.
همچنین ترکیب مانیتورینگ با ابزارهای تحلیل لاگ، سیستمهای SIEM و فناوریهای مبتنی بر هوش مصنوعی، دید جامعی از وضعیت زیرساخت در اختیار مدیران فناوری اطلاعات قرار میدهد و زمان تشخیص و رفع مشکلات را به حداقل میرساند.
اگر سازمان شما از VMware، Hyper-V، Proxmox، KVM یا هر بستر مجازیسازی دیگری استفاده میکند، پیادهسازی یک راهکار جامع برای مانیتورینگ ماشینهای مجازی میتواند نقش مهمی در افزایش پایداری سرویسها، کاهش هزینههای عملیاتی، بهبود امنیت و ارتقای کیفیت خدمات ایفا کند. سرمایهگذاری در مانیتورینگ، در واقع سرمایهگذاری بر روی پایداری و آینده زیرساخت فناوری اطلاعات سازمان است.
دیدگاه ها بسته هستند