آیا میتوان یک هوش مصنوعی قدرتمند را بدون اینترنت روی سرور نصب کرد؟
اگر چند سال قبل این سؤال را مطرح میکردید، پاسخ تقریباً منفی بود. بیشتر مدلهای هوش مصنوعی تنها از طریق سرویسهای ابری در دسترس بودند و برای استفاده از آنها باید اطلاعات خود را به سرورهای شرکتهای ارائهدهنده ارسال میکردید. این موضوع برای بسیاری از سازمانها، بانکها، مراکز درمانی، دانشگاهها، شرکتهای نرمافزاری و تیمهای امنیت اطلاعات یک نگرانی جدی محسوب میشد.
امروز شرایط کاملاً تغییر کرده است.
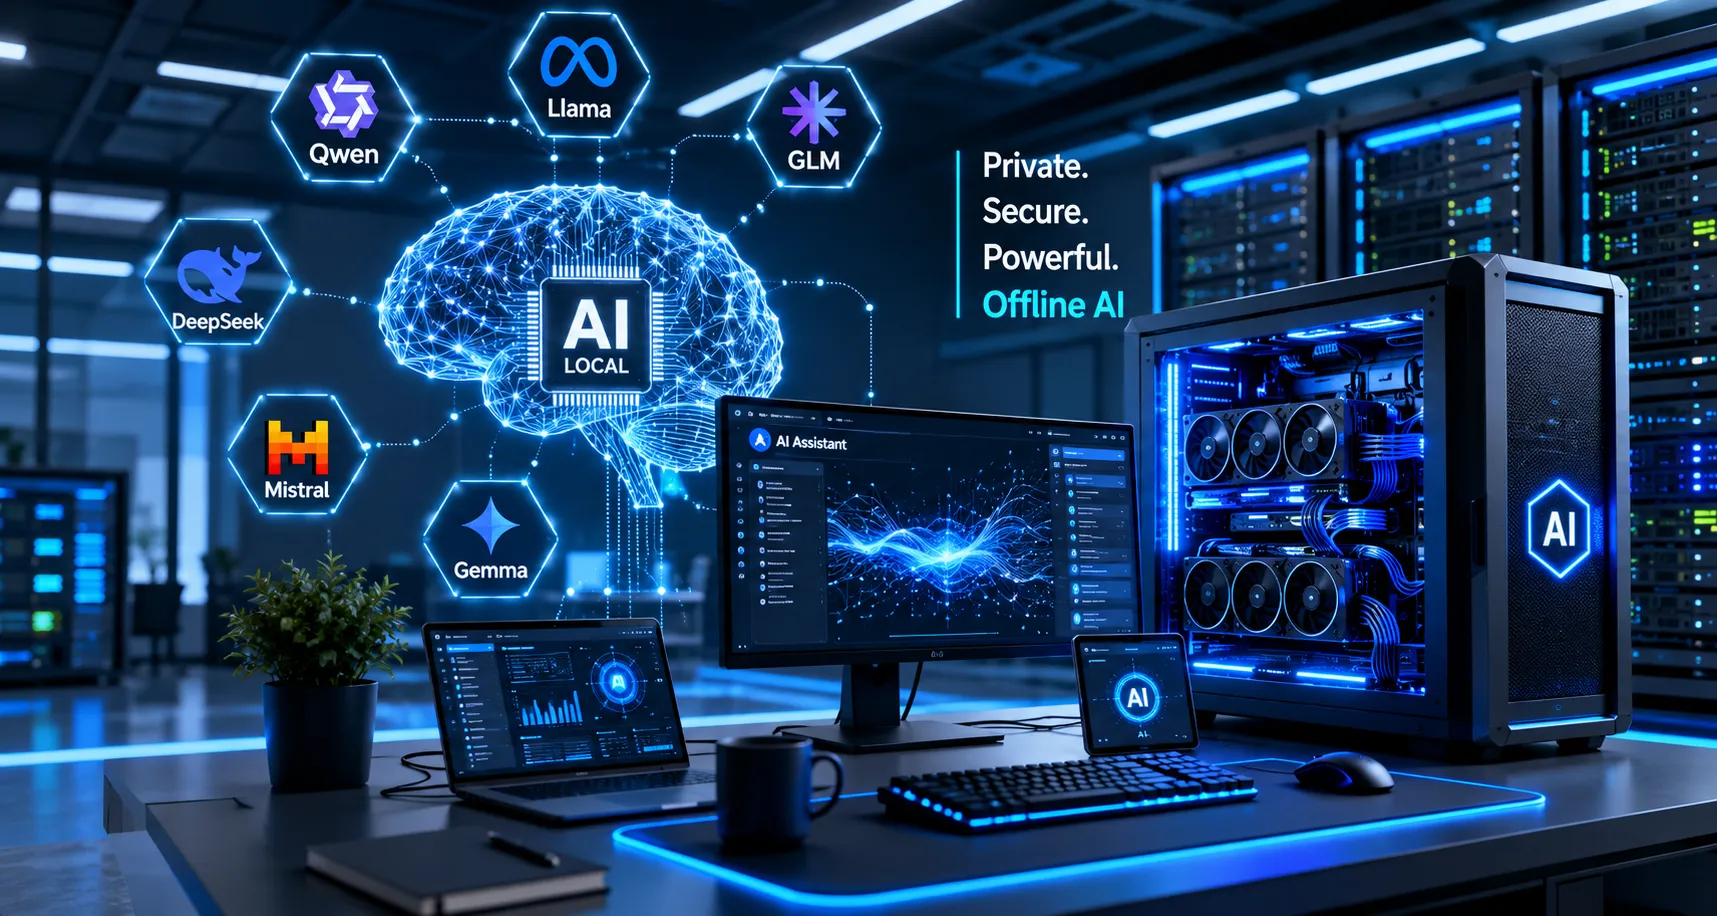
مدلهای Open Weight و Open Source به بلوغ رسیدهاند و اکنون میتوانید یک مدل هوش مصنوعی قدرتمند را روی سرور اختصاصی، ماشین مجازی یا حتی یک ورکاستیشن مجهز به کارت گرافیک حرفهای اجرا کنید. تمام پردازشها داخل زیرساخت شما انجام میشوند و اطلاعات حساس سازمان هرگز محیط داخلی را ترک نمیکنند.
به همین دلیل، استفاده از Offline AI یا On-Premise AI به یکی از مهمترین روندهای فناوری اطلاعات در سال ۲۰۲۶ تبدیل شده است.
Offline AI چیست؟
Offline AI به اجرای مدلهای هوش مصنوعی روی زیرساخت داخلی سازمان گفته میشود؛ بدون اینکه برای تولید پاسخ یا پردازش دادهها به اینترنت یا سرویسهای ابری وابسته باشد.
در این معماری، مدل زبانی (LLM)، پایگاه داده برداری (Vector Database)، موتور استنتاج (Inference Engine) و رابط کاربری همگی داخل شبکه داخلی سازمان اجرا میشوند.
در نتیجه، سازمان کنترل کامل بر دادهها، امنیت، عملکرد و هزینههای خود خواهد داشت.
چرا سازمانها به سمت هوش مصنوعی آفلاین مهاجرت میکنند؟
در سالهای اخیر، رشد سریع مدلهای زبانی بزرگ باعث شده بسیاری از شرکتها از ابزارهای ابری برای تولید محتوا، برنامهنویسی، تحلیل داده و پاسخگویی هوشمند استفاده کنند. با وجود مزایای این سرویسها، نگرانیهای مهمی نیز وجود دارد؛ از جمله امنیت اطلاعات، حفظ محرمانگی دادهها، قوانین حاکم بر انتقال اطلاعات و هزینههای اشتراک.
به همین دلیل، بسیاری از سازمانها ترجیح میدهند مدل هوش مصنوعی را مستقیماً روی زیرساخت خود اجرا کنند تا کنترل کامل بر دادهها و عملکرد سیستم داشته باشند.
مهمترین مزایای نصب هوش مصنوعی روی سرور
عدم ارسال اطلاعات محرمانه به اینترنت
حفظ کامل حریم خصوصی سازمان
حذف هزینه اشتراک ماهانه سرویسهای ابری
پاسخدهی سریعتر در شبکه داخلی
امکان اتصال به اسناد و پایگاه دانش سازمان
قابلیت توسعه Agentهای اختصاصی
امکان استفاده در شبکههای ایزوله (Air-Gapped)
سفارشیسازی مدل برای نیازهای سازمان
اتصال مستقیم به SIEM، Help Desk، CRM و ERP
اجرای همزمان برای صدها یا هزاران کاربر
هوش مصنوعی آفلاین چه کاربردهایی دارد؟
امروزه مدلهای LLM فقط برای چت کردن استفاده نمیشوند. بسیاری از سازمانها آنها را به بخشی از فرآیندهای روزمره خود تبدیل کردهاند.
برخی از مهمترین کاربردها عبارتاند از:
- دستیار هوشمند کارکنان
- تولید مستندات فنی
- تولید کد و بررسی برنامهها
- تحلیل لاگهای سرور
- پاسخگویی به رخدادهای امنیتی
- تحلیل آسیبپذیریها
- جستجو در میلیونها سند
- پاسخگویی به مشتریان
- تحلیل قراردادهای حقوقی
- ترجمه تخصصی
- خلاصهسازی اسناد
- تولید گزارشهای مدیریتی
- تحلیل دادههای سازمانی
- ساخت Agentهای هوشمند
- پردازش اسناد پزشکی و مالی
بهترین مدلهای هوش مصنوعی قابل نصب روی سرور
اگر عبارت Best Open Source LLM را جستجو کنید، با دهها مدل مختلف روبهرو میشوید. اما همه آنها کیفیت، سرعت یا امکانات یکسانی ندارند.
در ادامه با مهمترین مدلهای سال ۲۰۲۶ آشنا میشویم.
1. Qwen 3
اگر بخواهیم فقط یک مدل را به بیشتر سازمانها پیشنهاد کنیم، احتمالاً Qwen 3 یکی از بهترین انتخابها خواهد بود.
این مدل که توسط Alibaba توسعه داده شده، در برنامهنویسی، استدلال منطقی، چندزبانه بودن و عملکرد روی زبان فارسی نتایج بسیار خوبی ارائه میدهد.
نقاط قوت
- عملکرد عالی در زبان فارسی
- کیفیت بسیار بالا در برنامهنویسی
- پشتیبانی از Context طولانی
- مناسب برای RAG
- مناسب برای Agent
- Function Calling
- سرعت بالا
مناسب برای
- شرکتهای نرمافزاری
- بانکها
- دانشگاهها
- مراکز امنیت اطلاعات
- DevOps
- SOC
- تولید محتوا
2. GLM-5.2
یکی از جدیدترین مدلهای متنباز که توجه بسیاری از متخصصان را جلب کرده، GLM-5.2 است.
این مدل با تمرکز بر استدلال، Agentها، تحلیل اسناد و پردازش Contextهای بسیار بزرگ توسعه یافته و برای سازمانهایی که با حجم زیادی از اطلاعات سروکار دارند، گزینهای جذاب محسوب میشود.
مزایا
- Context بسیار بزرگ
- معماری MoE
- عملکرد عالی در تحلیل اسناد
- مناسب برای پروژههای سازمانی
- قابلیت استقرار روی زیرساخت داخلی
3. Llama 3.3
مدل Llama که توسط Meta توسعه یافته، یکی از محبوبترین خانوادههای مدلهای متنباز است و جامعه توسعهدهندگان بسیار بزرگی دارد.
بسیاری از ابزارهای هوش مصنوعی از این مدل پشتیبانی میکنند و به همین دلیل استقرار آن معمولاً سادهتر از برخی مدلهای دیگر است.
مزایا
- جامعه کاربری بزرگ
- مستندات فراوان
- کیفیت مناسب
- سازگاری بالا با ابزارهای مختلف
- گزینهای مطمئن برای پروژههای سازمانی
4. DeepSeek-R1
اگر هدف شما تحلیل منطقی، استدلال پیچیده یا تولید کد است، DeepSeek-R1 یکی از بهترین گزینههای موجود به شمار میرود.
این مدل در حل مسائل پیچیده، تحلیل چندمرحلهای و پاسخ به پرسشهای تخصصی عملکرد بسیار خوبی دارد.
5. Gemma 3
Gemma که توسط Google توسعه یافته، مدل سبکتر و بهینهتری است و برای سازمانهایی که سختافزار محدودتری دارند، انتخاب مناسبی محسوب میشود.
6. Mistral
Mistral یکی از سریعترین مدلهای متنباز بازار است و برای پردازشهای بلادرنگ، چتباتها و سامانههای پاسخگویی هوشمند عملکرد قابل توجهی دارد.
مقایسه کامل بهترین مدلهای هوش مصنوعی قابل نصب روی سرور
انتخاب یک مدل هوش مصنوعی مناسب، فقط به تعداد پارامترها یا شهرت آن بستگی ندارد. هر مدل برای سناریوهای خاصی طراحی شده است. بعضی مدلها در برنامهنویسی عملکرد فوقالعادهای دارند، برخی در تحلیل اسناد و استدلال منطقی برتری دارند و بعضی دیگر برای اجرای سریع روی سختافزارهای محدود بهینه شدهاند.
اگر قصد دارید یک دستیار هوش مصنوعی سازمانی راهاندازی کنید، باید قبل از انتخاب مدل، چند سؤال کلیدی را از خود بپرسید:
- آیا مدل قرار است به اینترنت متصل باشد یا کاملاً آفلاین اجرا شود؟
- تعداد کاربران همزمان چقدر است؟
- تمرکز اصلی روی برنامهنویسی است یا تحلیل اسناد؟
- آیا زبان فارسی برای شما اهمیت دارد؟
- چه مقدار VRAM و RAM در اختیار دارید؟
- آیا قصد دارید از RAG و پایگاه دانش داخلی استفاده کنید؟
پاسخ این پرسشها، انتخاب مدل مناسب را بسیار سادهتر میکند.
جدول مقایسه بهترین مدلهای LLM در سال ۲۰۲۶
| مدل | مناسب برای فارسی | برنامهنویسی | استدلال (Reasoning) | سرعت | مناسب RAG | مناسب Agent | سختافزار پیشنهادی |
|---|---|---|---|---|---|---|---|
| Qwen 3 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | RTX 4090 / RTX 5090 |
| GLM-5.2 | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | چند GPU |
| Llama 3.3 | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | RTX 4090 |
| DeepSeek-R1 | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐☆☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | چند GPU |
| Gemma 3 | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | RTX 4070 / RTX 4090 |
| Mistral | ⭐⭐⭐☆☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐☆ | ⭐⭐⭐⭐☆ | RTX 4070 |
اگر زبان فارسی برای شما مهم است
بسیاری از مدلهای متنباز ابتدا برای زبان انگلیسی آموزش دیدهاند، اما برخی از آنها عملکرد قابل قبولی در فارسی نیز دارند.
بهترین گزینهها برای فارسی
Qwen 3
GLM-5.2
Llama 3.3
این مدلها در درک متن، تولید محتوا، ترجمه، خلاصهسازی و پاسخ به پرسشهای فارسی کیفیت مناسبی ارائه میدهند.
بهترین مدل برای برنامهنویسی
اگر تیم توسعه نرمافزار دارید یا میخواهید یک دستیار هوشمند برای برنامهنویسان راهاندازی کنید، این مدلها بهترین انتخاب هستند:
Qwen 3
- تولید کد
- Debug
- Refactoring
- توضیح کد
- تولید Unit Test
DeepSeek-R1
- تحلیل الگوریتم
- حل مسائل پیچیده
- طراحی معماری نرمافزار
- تحلیل چندمرحلهای
GLM-5.2
- Agentهای برنامهنویسی
- تحلیل پروژههای بزرگ
- مستندسازی خودکار
بهترین مدل برای امنیت اطلاعات (SOC)
یکی از جذابترین کاربردهای LLM، استفاده در مراکز عملیات امنیت (SOC) است.
این مدلها میتوانند:
- لاگها را تحلیل کنند.
- هشدارهای SIEM را بررسی کنند.
- Ruleهای امنیتی تولید کنند.
- اسکریپتهای PowerShell و Bash بنویسند.
- گزارش Incident Response تولید کنند.
- آسیبپذیریها را توضیح دهند.
- راهکارهای کاهش ریسک پیشنهاد کنند.
پیشنهاد Rootnet
Qwen 3 + RAG + Open WebUI + vLLM
این ترکیب تعادل بسیار خوبی بین سرعت، دقت و هزینه ایجاد میکند و برای بسیاری از سازمانها انتخاب مناسبی است.
بهترین مدل برای تولید محتوا
اگر هدف شما تولید مقاله، مستندات، ایمیلهای سازمانی یا گزارشهای فنی است:
- Qwen 3
- Llama 3.3
- GLM-5.2
این مدلها توانایی تولید متنهای طولانی، ساختاریافته و روان را دارند.
بهترین مدل برای RAG
در معماری RAG، مدل زبانی به پایگاه دانش سازمان متصل میشود و به جای تکیه بر اطلاعات عمومی، از اسناد داخلی برای تولید پاسخ استفاده میکند.
مدلهای زیر برای این کاربرد عملکرد مناسبی دارند:
- Qwen 3
- GLM-5.2
- DeepSeek-R1
- Llama 3.3
این مدلها میتوانند اطلاعات را از هزاران سند، فایل PDF، مستندات فنی و ویکی داخلی بازیابی و در پاسخهای خود استفاده کنند.
اگر سختافزار قدرتمندی ندارید چه مدلی انتخاب کنید؟
همه سازمانها بودجه خرید چند GPU دیتاسنتری را ندارند. خوشبختانه نسخههای کوچکتر بسیاری از مدلها روی کارتهای گرافیک ردهمصرفی نیز قابل اجرا هستند.
سیستم اقتصادی
- RTX 4060 Ti
- RTX 4070
- 64GB RAM
مناسب برای مدلهای 7B و 8B.
سیستم حرفهای
- RTX 4090
- RTX 5090
- 128GB RAM
مناسب برای مدلهای 14B تا 32B.
سیستم سازمانی
- چند GPU حرفهای
- 256GB تا 512GB RAM
- پردازندههای AMD EPYC یا Intel Xeon
مناسب برای مدلهای بزرگ و تعداد زیاد کاربران همزمان.
انتخاب مدل بر اساس نیاز
| نیاز | پیشنهاد |
|---|---|
| زبان فارسی | Qwen 3 |
| برنامهنویسی | Qwen ۳ یا DeepSeek-R1 |
| تحلیل امنیت | Qwen 3 + RAG |
| تولید محتوا | Qwen ۳ یا Llama ۳.۳ |
| تحلیل اسناد حجیم | GLM-5.2 |
| اجرای روی سختافزار متوسط | Gemma ۳ یا Mistral |
| Agentهای هوشمند | GLM-۵.۲ یا Qwen ۳ |
نتیجهگیری؛ کدام مدل هوش مصنوعی برای نصب روی سرور بهترین انتخاب است؟
پاسخ این سؤال به نیازهای سازمان، بودجه، زیرساخت سختافزاری و نوع استفاده شما بستگی دارد. برخلاف تصور بسیاری از کاربران، بهترین مدل هوش مصنوعی برای همه سناریوها یکسان نیست.
اگر به دنبال یک مدل همهجانبه با عملکرد عالی در زبان فارسی، برنامهنویسی، تحلیل اسناد، RAG و Agentهای هوشمند هستید، Qwen 3 یکی از بهترین گزینههای موجود است.
اگر پروژه شما روی تحلیل اسناد بسیار بزرگ، پردازش Context طولانی و توسعه Agentهای پیشرفته متمرکز است، GLM-5.2 انتخاب بسیار قدرتمندی خواهد بود.
برای پروژههای متنباز با جامعه کاربری گسترده و سازگاری بالا، Llama 3.3 همچنان یکی از محبوبترین گزینهها محسوب میشود.
اگر اولویت شما استدلال منطقی، تحلیل پیچیده و تولید کد است، DeepSeek-R1 عملکرد بسیار قابل توجهی ارائه میدهد.
در مقابل، اگر سختافزار محدودتری در اختیار دارید و به دنبال مصرف منابع کمتر هستید، Gemma 3 و Mistral میتوانند انتخابهای مناسبی باشند.
نکته مهم این است که موفقیت یک پروژه هوش مصنوعی تنها به انتخاب مدل وابسته نیست. طراحی صحیح زیرساخت، انتخاب موتور استنتاج مناسب، استفاده از پایگاه داده برداری، پیادهسازی RAG، بهینهسازی سختافزار و نگهداری مستمر، نقش بسیار مهمی در کیفیت نهایی سیستم خواهند داشت.
اگر قصد راهاندازی یک دستیار هوش مصنوعی داخلی برای شرکت، سازمان یا مرکز داده خود را دارید، پیشنهاد میشود قبل از انتخاب مدل، نیازهای واقعی کسبوکار، حجم کاربران، نوع دادهها و بودجه سختافزاری را بهدقت بررسی کنید.
سوالات متداول (FAQ)
۱. آیا میتوان مدلهای هوش مصنوعی را کاملاً آفلاین روی سرور اجرا کرد؟
بله. بسیاری از مدلهای متنباز مانند Qwen، GLM، Llama، DeepSeek، Gemma و Mistral را میتوان بدون نیاز به اینترنت روی سرور، ورکاستیشن یا ماشین مجازی اجرا کرد.
۲. بهترین مدل هوش مصنوعی برای زبان فارسی کدام است؟
در حال حاضر Qwen ۳ یکی از بهترین مدلها برای پردازش و تولید متن فارسی محسوب میشود. GLM-۵.۲ و Llama ۳.۳ نیز عملکرد مناسبی دارند.
۳. آیا برای اجرای LLM حتماً به کارت گرافیک نیاز است؟
خیر، اما استفاده از GPU سرعت پردازش را بهطور قابل توجهی افزایش میدهد. مدلهای کوچک روی CPU نیز اجرا میشوند، اما پاسخدهی آنها معمولاً کندتر است.
۴. حداقل سختافزار موردنیاز برای اجرای مدلهای هوش مصنوعی چیست؟
برای مدلهای 7B معمولاً یک GPU با ۸ تا ۱۶ گیگابایت VRAM و حداقل ۳۲ تا ۶۴ گیگابایت RAM پیشنهاد میشود. مدلهای بزرگتر به منابع بیشتری نیاز دارند.
۵. آیا این مدلها از زبان فارسی پشتیبانی میکنند؟
بله. اکثر مدلهای جدید از زبان فارسی پشتیبانی میکنند، اما کیفیت آنها متفاوت است. Qwen ۳ در بسیاری از آزمونها عملکرد بسیار خوبی در فارسی نشان داده است.
۶. تفاوت هوش مصنوعی آفلاین با سرویسهای ابری چیست؟
در مدل آفلاین، تمام پردازشها داخل زیرساخت شما انجام میشود و دادهها از سازمان خارج نمیشوند. در سرویسهای ابری، درخواستها برای پردازش به سرورهای ارائهدهنده ارسال میشوند.
۷. آیا میتوان مدلهای هوش مصنوعی را به اسناد داخلی سازمان متصل کرد؟
بله. با استفاده از معماری RAG و پایگاههای داده برداری، مدل میتواند به مستندات، فایلهای PDF، ویکی داخلی و سایر منابع سازمان متصل شود و پاسخهای دقیقتری ارائه دهد.
۸. بهترین نرمافزار برای اجرای مدلهای هوش مصنوعی چیست؟
ابزارهایی مانند Ollama، vLLM، Open WebUI، llama.cpp و Text Generation Inference از محبوبترین گزینهها برای استقرار مدلهای هوش مصنوعی هستند.
۹. آیا اجرای مدلهای هوش مصنوعی روی VMware یا Proxmox امکانپذیر است؟
بله. در صورت دسترسی ماشین مجازی به منابع سختافزاری موردنیاز، بسیاری از مدلها را میتوان در محیطهای مجازی نیز اجرا کرد.
۱۰. آیا مدلهای متنباز برای استفاده تجاری مناسب هستند؟
بله، اما باید شرایط مجوز (License) هر مدل را بررسی کنید. بسیاری از مدلهای جدید امکان استفاده تجاری را نیز فراهم میکنند.
۱۱. آیا میتوان مدل هوش مصنوعی را برای دادههای اختصاصی سازمان آموزش داد؟
بله. بسته به مدل، میتوانید از روشهایی مانند Fine-tuning، LoRA یا RAG برای سازگار کردن مدل با دادهها و نیازهای سازمان استفاده کنید.
۱۲. برای یک سازمان با ۱۰۰ کاربر همزمان چه زیرساختی پیشنهاد میشود؟
پاسخ به تعداد درخواستها، اندازه مدل و زمان پاسخ مورد انتظار بستگی دارد، اما معمولاً استفاده از GPUهای حرفهای، حافظه RAM کافی و یک موتور استنتاج بهینه مانند vLLM انتخاب مناسبی برای چنین سناریوهایی است.
جمعبندی
مدلهای هوش مصنوعی متنباز، مسیر جدیدی را برای توسعه دستیارهای هوشمند، تحلیل داده، امنیت اطلاعات، برنامهنویسی و مدیریت دانش سازمانی ایجاد کردهاند. انتخاب مدل مناسب باید بر اساس نیازهای واقعی، منابع سختافزاری و اهداف پروژه انجام شود. با طراحی صحیح زیرساخت و انتخاب ابزارهای مناسب، میتوان یک سامانه هوش مصنوعی قدرتمند، امن و کاملاً آفلاین ایجاد کرد که سالها پاسخگوی نیازهای سازمان باشد.
دیدگاه ها بسته هستند